Google TPU 影片生成加速:如何透過「時空稀疏注意力」實現 1.69 倍效能提升
Accelerating Video Diffusion on TPUs: Optimizing Spatio-Temporal Sparse Attention
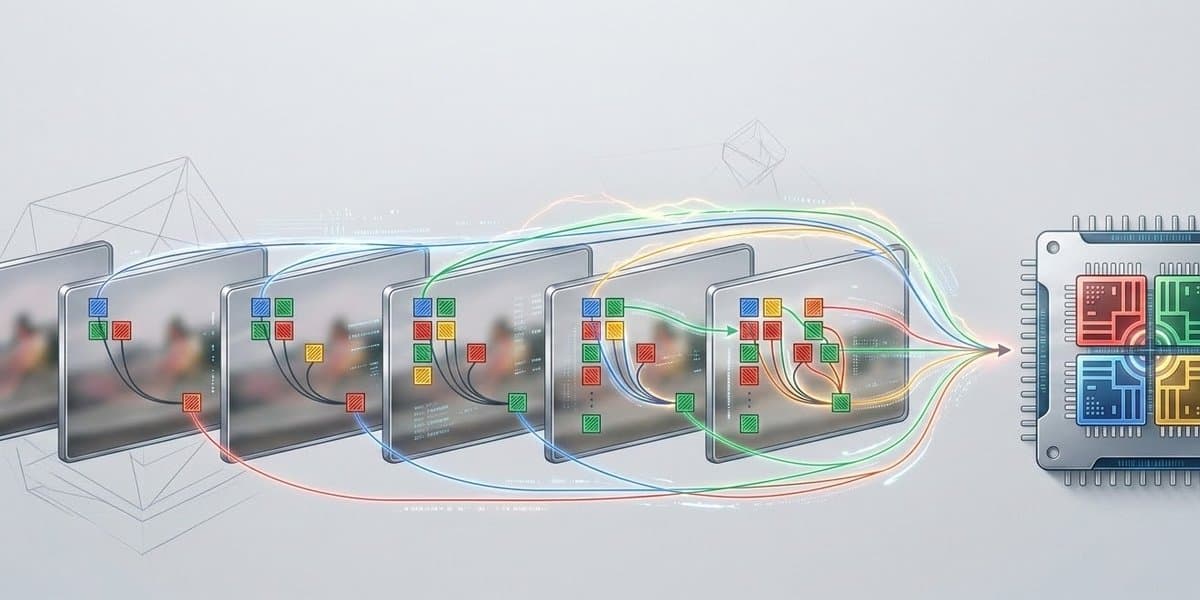
高解析度影片擴散模型因自注意力機制的二次方特性,在 1440p (2K) 下的自注意力運算佔比高達 88.2%。Google 團隊利用「稀疏影片生成」(SVG)將注意力標頭動態分流為空間或時間遮罩,並針對 TPU v6e 進行三階段軟硬體協同優化:包含跳過空分塊、設計無遮罩快速路徑、微調遮罩邊界對齊分塊,以及在分散式推論中實施本地 Token 重排。這些改進成功解決了 TPU 的向量處理器瓶頸,顯著降低了影片生成的運算成本。
核心重點
時空注意力分流
動態將注意力標頭分配至空間或時間遮罩,保留第一影格作為全域外觀錨點(attention sink)。
分塊特化與對齊
區分完全保留塊與邊界塊,避免在全保留區塊上執行昂貴的元素級遮罩評估,使核心速度提升 2.4 倍。
本地 Token 重排
將時間維度的 Token 重排限制在裝置本地(Head-local)執行,避免跨裝置通訊,使注意力延遲降低 38%。
高解析度顯著加速
在 1440p(302K tokens)影片生成中,端到端速度提升 1.69 倍,每部影片生成節省超過 16 分鐘。
技術圖解
為什麼重要
這項研究展示了演算法的「理論稀疏性」如何透過緊密的硬體協同設計(Pallas kernel 實作)轉化為「硬體實際加速」。對於開發高解析度、長影片生成模型的團隊,本方案證明了不需犧牲生成品質(維持 24.05 dB PSNR),即可在雲端 TPU 叢集上大幅降低推論成本與時間。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1高解析度(1080p 至 2K)影片擴散模型推論加速
- 2分散式 TPU 叢集上的高效能長序列自注意力運算
限制與注意事項
- 稀疏遮罩邊界的微調與捨入會稍微改變注意力分佈,需平衡畫質(PSNR)與加速比之間的權衡。
- 該實作高度依賴 TPU v6e、JAX 和 Pallas Splash Attention 核心,移植到 GPU 等其他硬體架構需要重構。
延伸閱讀
ViTeX-Bench:解決影片場景文字編輯難題的首個高保真基準測試
ViTeX-Bench: Benchmarking High-Fidelity Video Scene Text Editing
研究團隊推出 ViTeX-Bench 基準測試與 14B 開源參考模型,解決影片場景中招牌、白板等局部文字修改時,文字正確性與畫面時間軸穩定性難以兼顧的挑戰。
NVIDIA VSS Blueprint 3.3 登場:以智慧採樣與 AI 代理技能,大幅降低視覺 AI 部署成本
NVIDIA VSS Blueprint 3.3: Lowering Visual AI Agent Costs with Smart Sampling and Agent Skills
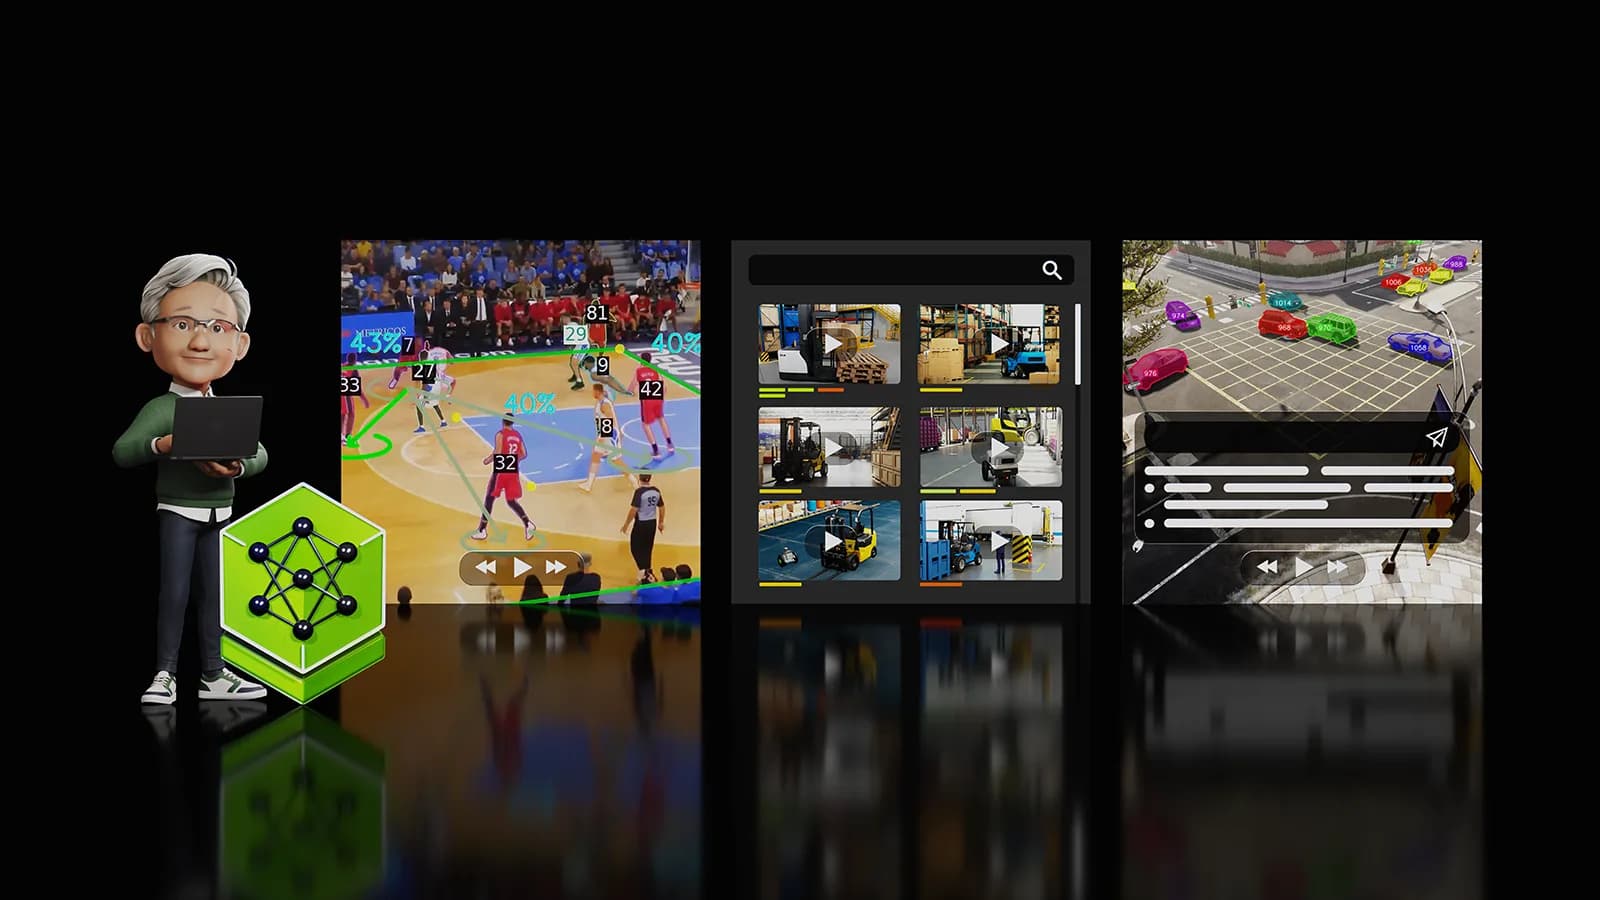
NVIDIA 推出 VSS Blueprint 3.3,透過全新的視覺代理建構技能與自適應高效視訊採樣(Adaptive EVS)技術,大幅簡化多工作流開發流程並減少高達 80% 的 VLM 輸入 Token,顯著降低開發與運行成本。
超越時間線:利用「實體自傳」增強 AI 的長影片記憶與物體追蹤能力
Beyond the Timeline: Augmenting Long-Video Memory with Grounded Entity Biographies
本研究提出 Grounded Entity Biographies (GEB) 記憶框架,將影片中同一物理實體的跨片段視覺觀測,自動串聯成可檢索的「實體自傳」,大幅提升 AI 在長達數天之長影片問答中的物體追蹤與識別能力。