微軟開源 Agent Lightning v1.0:僅 3,500 行程式碼,直接用生產環境 Harness 訓練 Agent 的強化學習框架
Microsoft Releases Agent Lightning v1.0: A 3,500-Line Lightweight Agentic RL Framework for Real-Harness Training
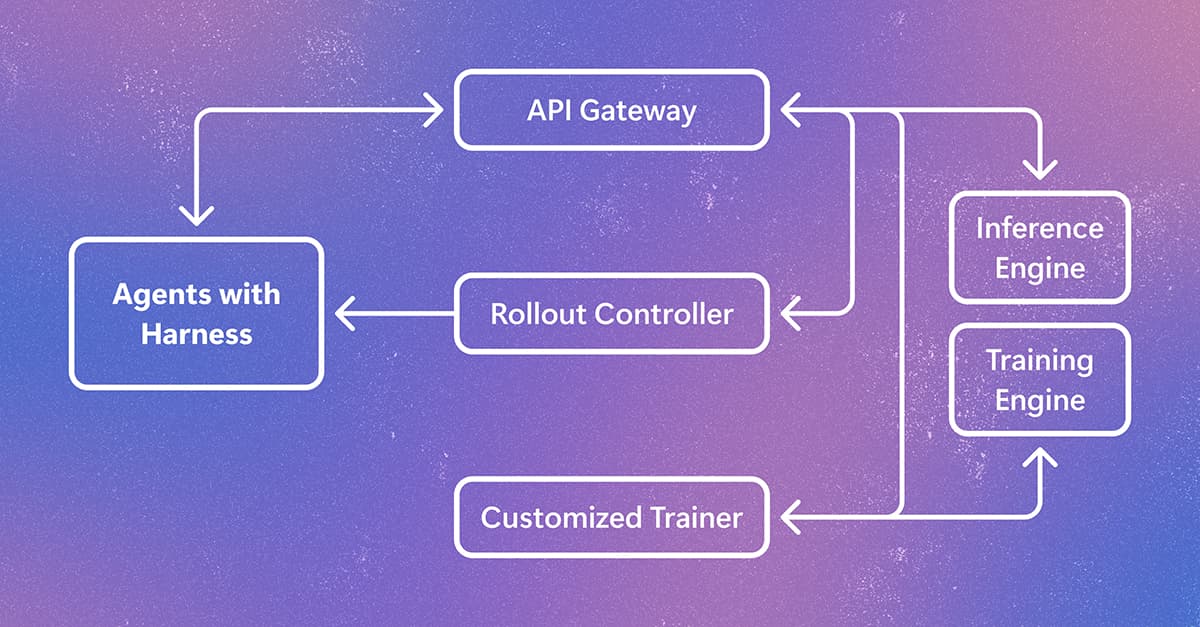
傳統 Agent 強化學習(RL)需要將 Agent 的工具呼叫與環境互動邏輯在訓練框架中重新編寫,這不僅耗費成本,更易導致訓練與實際部署的行為不一致。微軟推出的 Agent Lightning v1.0 透過在 Agent 套件與模型之間建立 LLM 代理(Proxy),實現「Harnessed Agentic RL」——直接以生產環境的 Harness 參與 RL 訓練。框架僅約 3,500 行程式碼,支援原生 Kubernetes 部署(免去商業沙盒費用),並引入「同置非同步 RL」使 Rollout 與模型更新共享 GPU,提升 2 倍訓練速度。實驗中僅用 6,000 個樣本,便將 Qwen3.5-9B 在 SWE-bench Verified 的 Pass@1 分數從 41.8% 提升至 56.4%。
核心重點
真實 Harness 直接訓練
利用 LLM 代理攔截並記錄對話與工具調用,不需為訓練重新編寫複雜的 Agent 互動邏輯。
極致輕量與極佳可擴展性
核心控制台僅約 3,500 行程式碼,由 API 網關、Rollout 控制器與自定義訓練器組成,易於理解與修改。
同置非同步 RL 技術
允許 Rollout 與模型更新在同一組 GPU 上交替運行,達到 2 倍速度提升並顯著減少 GPU 閒置。
原生 Kubernetes 支援
將 Agent 執行視為標準 K8s 工作負載,不再依賴 Modal Sandbox 或 E2B 等付費商業沙盒服務。
技術圖解
為什麼重要
此研究解決了 Agent 開發中「訓練與部署環境不一致」的痛點。過去為了強化學習,開發者必須在 RL 框架中痛苦地重構 Agent。Agent Lightning 透過代理機制,讓既有的 Coding 代理(如 OpenHands 或 Claude Code)能直接接上 RL 訓練。加上開源的 K8s 整合和 GPU 共享架構,大幅降低了中小企業與研究團隊調優專屬 Agent 的資金和算力門檻。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1軟體開發 Agent 強化學習(如最佳化解決 GitHub Issue 的能力)
- 2無縫同步生產環境與訓練環境的 Agent 部署流程
限制與注意事項
- 將多個 API 呼叫切分為訓練樣本時,重新 Token 化(Retokenization)可能導致邊界偏移與上下文合併困難。
- 當 Rollout 產生大量且長度不一的樣本時,如何將變動的訓練負載均勻分配給固定配置的 GPU 後端仍具挑戰。
延伸閱讀
RECAST:透過自適應證據路由,為 LLM 計算出正確的上下文
RECAST: Active Evidence Construction via Adaptive Routing and Computation
RECAST 是一種全新的 Agent 框架,將「證據建構」視為循序決策過程,透過輕量級 RouterLM 結合程式碼編譯與計算,主動為 LLM 產出精準答案所需的上下文,而非僅依靠傳統 RAG 的靜態相似度檢索。
打造低成本 AI 工件:LLM Agent 是否具備「能力封裝」的本領?
Agent in a Bottle: Can LLM Agents Package Their Capabilities into Cheap, Scalable Artifacts?
本研究提出 BOTTLED 基準測試,評估 LLM Agent 能否在預算限制下,自動將通用推理能力「封裝」成便宜且可擴展的特定任務小模型或程式,並揭示了零樣本能力不等於封裝能力的現狀。
利用 Web 世界模型進行對抗訓練:AdvSim2Real 提升 Web Agent 抵禦適應性提示詞注入之能力
AdvSim2Real: Co-Evolving Web Agents and Adversaries inside a Web World Model
AdvSim2Real 透過在虛擬的 Web 世界模型中協同演化任務課程、注入攻擊者與 Agent,成功在不降低一般任務完成率的前提下,大幅提升 4B 輕量級 Agent 抵禦未見過提示詞注入攻擊的能力。