破解電力瓶頸:NVIDIA DSX MaxLPS 如何釋放 AI 工廠高達 40% 的隱形算力
Unlocking Stranded Capacity: How NVIDIA DSX MaxLPS Boosts AI Factory Throughput by 49%
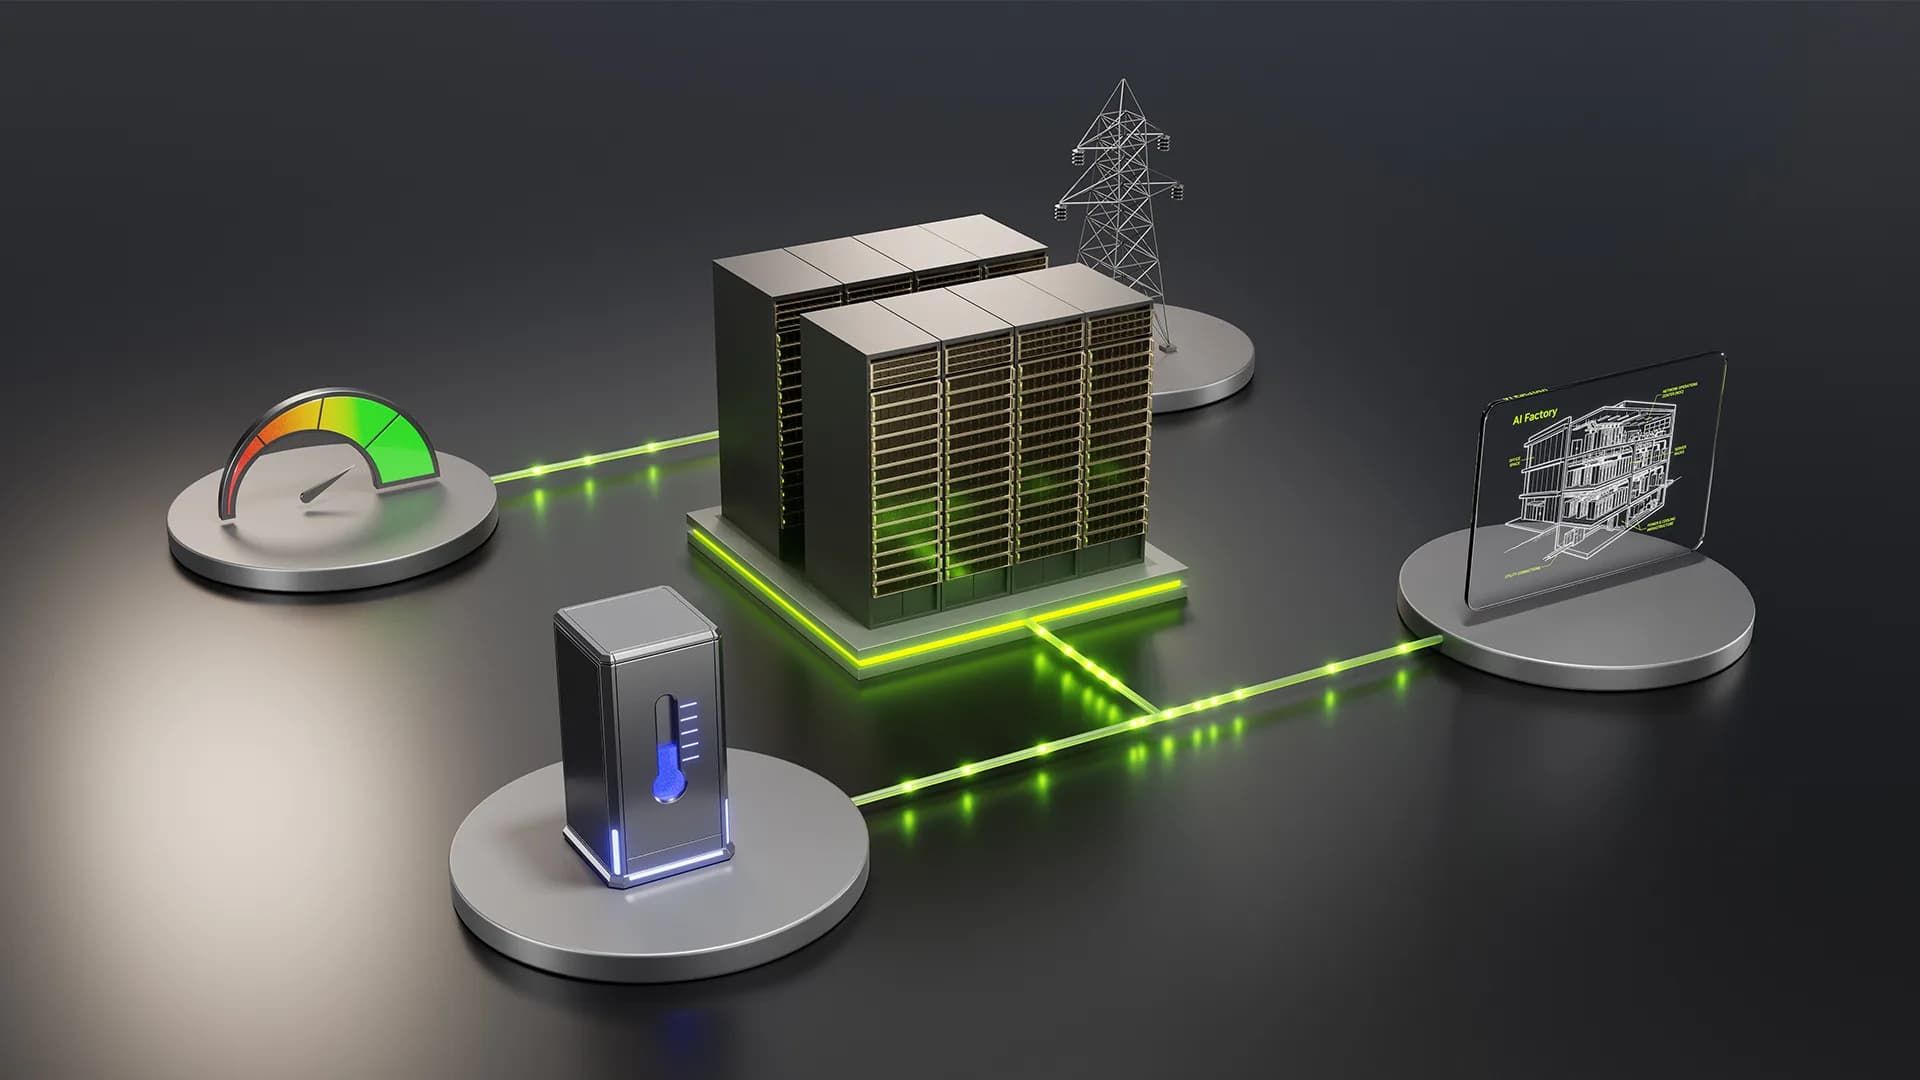
傳統 AI 工廠常以 GPU 最高峰值電力進行保守規劃,導致平時大量電力預算閒置。NVIDIA 推出的 DSX MaxLPS 技術,透過即時監測與策略性電力分配,打破靜態限制。在冰島 Nscale 資料中心以 Blackwell 架構的 GB300 NVL72 系統運行 Kimi K2.5 模型進行的實測中,DSX MaxLPS 在不改變 264.4 kW 電力預算的前提下,成功將管理 GPU 從 140 顆提升至 192 顆,使總吞吐量暴增 49.2%,且未影響個別任務的常態表現。
核心重點
動態電力調配
透過即時監控 GPU、節點和機架的功耗,動態分配閒置電力,取代保守的靜態峰值預留。
吞吐量顯著提升
在不增加核定總電力預算的前提下,將總吞吐量與每瓦效能提升 49.2%。
核心效能保持穩定
各實例(Instance)的中位數與 P75 延遲變化在 5% 以內,確保常態服務品質。
漸進式導入與驗證
提供明確的驗證流程,從定義邊界、建立基準到逐步增加容量,確保系統容錯與穩定性。
技術圖解
| Static baseline (靜態基準) | DSX MaxLPS (動態調配) | |
|---|---|---|
| 管理 GPU 數量 | 140 | 192 (+37.1%) |
| 總吞吐量 (tokens/s) | 1,084,503 | 1,618,443 (+49.2%) |
| 每瓦特吞吐量 | 4.10 tokens/s/W | 6.12 tokens/s/W (+49.2%) |
| 電力預算利用率 | 62.9% | 75.2% (+12.3 pp) |
| 實測總功耗 (kW) | 166.2 kW | 198.9 kW (+19.7%) |
為什麼重要
隨著 AI 模型規模與算力需求暴增,電力已成為資料中心建設的最大瓶頸。DSX MaxLPS 證明了硬體與軟體協同設計的力量,不需等待新建電廠或升級電網,就能直接在現有電力限制下部署多達 40% 的 GPU。這對面臨供電限制的雲端服務商與大型企業而言,能立竿見影地降低每 token 的基礎設施成本,最大化 AI 投資報酬率。
對誰有影響
- 企業決策者
- AI 開發者
- 新創創辦人
可以怎麼使用
- 1面臨電力供應上限的 AI 算力工廠優化
- 2混合運行預訓練(Training)與推理(Inference)的異質工作負載機群管理
- 3綠色資料中心的高能效 LLM 大規模部署
限制與注意事項
- P99 尾端延遲(Time to First Token)增加了 17%,在高即時性要求的場景需特別評估。
- 高度依賴精準且無延遲的遙測(Telemetry)數據,若數據遺失或遲滯可能影響電力分配決策。
- 雖然調配了閒置電力,但平均功耗依然上升(實測增加約 19.7%),實體配電與散熱基礎設施仍須按最終容量規劃。
延伸閱讀
NVIDIA 開源 NVCRE:在 AI 工作負載上線前,自動驗證 GPU 叢集準備狀態
NVIDIA Launches Open-Source NVCRE: Automating GPU Cluster Readiness Validation Before AI Workloads Run
傳統的 GPU 健全狀況檢查常漏掉分散式訓練中的效能瓶頸。NVIDIA 開源的 NVCRE 是一款 Kubernetes 控制器,透過主動執行分散式測試工作負載,在生產部署前精準找出故障與效能退化的節點。
突破機密運算效能瓶頸:NVIDIA Blackwell 與 TensorRT-LLM 的隱私推理優化
Overcoming Confidential Computing Overheads: Optimizing Private LLM Inference on NVIDIA Blackwell
本文介紹 NVIDIA 如何透過 TensorRT-LLM 的架構級優化,在 B200 GPU 的機密運算環境下執行 DeepSeek-R1 推理,成功保留高達 98% 的吞吐量並控制延遲開銷。