NVIDIA 推出首款開源 3D CT 醫療視覺語言模型 NV-Reason-CT,導入放射科醫師思考鏈推論
NVIDIA Introduces NV-Reason-CT: Open 3D CT VLM with Radiologist Chain-of-Thought Reasoning
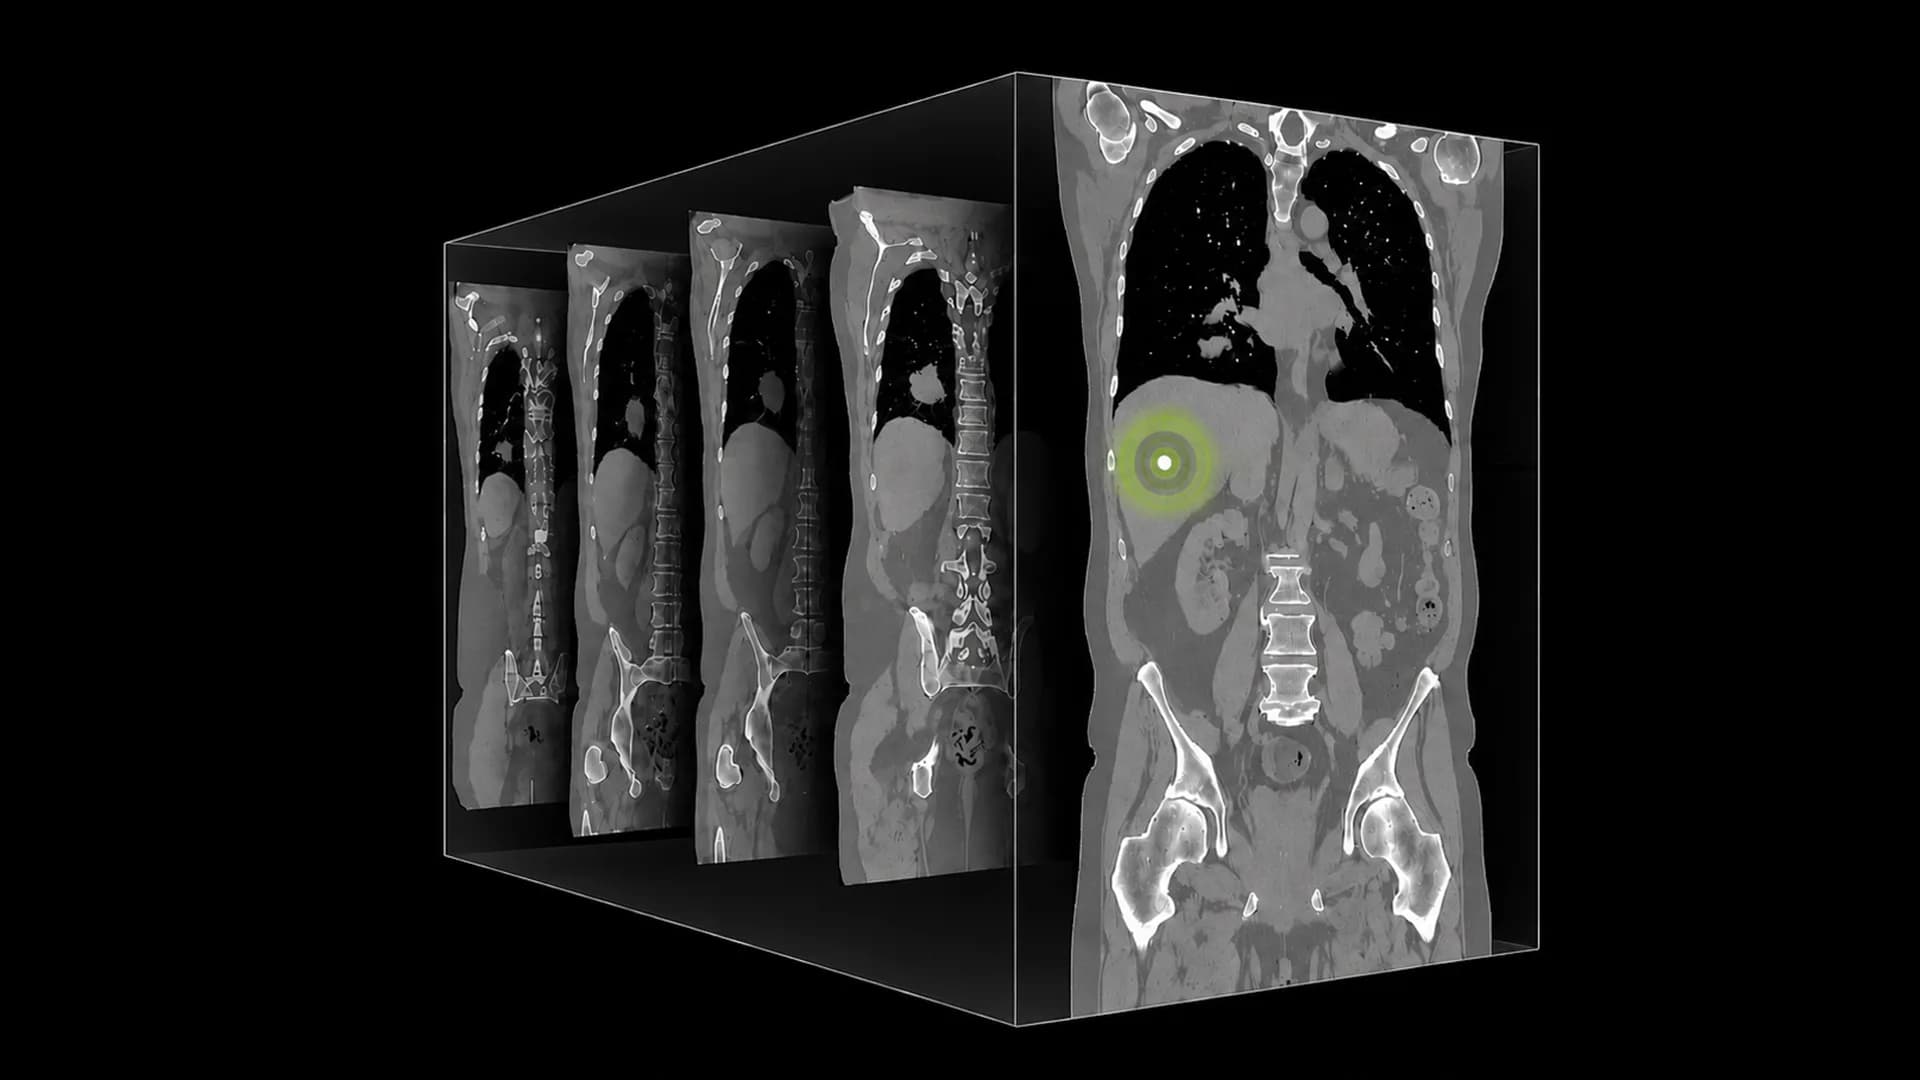
NV-Reason-CT 是專為 3D 電腦斷層(CT)設計的開源醫療視覺語言模型。相較於將 3D 影像拆解為 2D 切片的傳統做法,NV-Reason-CT 採用原生 3D 視覺編碼器(3D ViT)與 3D MRoPE 技術以完整保留解剖結構的空間連續性。模型採用 Qwen3.5-4B 為語言基礎,透過結合放射科醫師標註的兩階段訓練(監督微調與 GRPO 強化學習),能模擬醫師診斷時的思考鏈(CoT),有系統地分析胸腹腔病灶,並提供多輪對話式臨床問答。
核心重點
原生 3D 空間感知
捨棄傳統將 3D 影像拆為獨立 2D 切片的做法,採用 3D ViT 編碼器並結合 3D MRoPE,保留電腦斷層切片之間的解剖結構連續性。
模擬醫師診斷思考鏈
產生逐步的內部推論過程,有系統地檢視解剖區域、權衡鑑別診斷並表達不確定性,而非僅輸出單純的診斷標籤。
兩階段結構化訓練
先以 55 萬個包含專家推論路徑的問答資料進行監督微調,再使用群體相對策略優化(GRPO)強化學習演算法提升診斷準確性。
多輪交談式互動
支援多輪問答,讓臨床人員與研究員能針對特定的病灶進行追問或要求澄清,扮演互動式的診斷夥伴。
技術圖解
| Type | Macro-F1 | Macro-AUROC | |
|---|---|---|---|
| NV-Reason-CT | Native 3D generative VLM | 0.614 | 0.871 |
| VoxelFM | 3D image-only pretraining | 0.581 | 0.870 |
| Pillar-0 | 3D contrastive | 0.544 | 0.861 |
| ClinFusion-8B | Fused 2D/3D generative MLLM | 0.442 | n/r |
| MedGemma 1.5 | Up to 85 axial slices | 0.303 | n/r |
為什麼重要
傳統醫療 AI 模型多為「黑盒子」,僅給出標籤而無法說明原因,難以獲得臨床信任。NV-Reason-CT 作為開源基礎模型,提供可審計、可解釋的思考鏈推論。這不僅能大幅減輕放射科醫師撰寫結構化報告的認知負荷,還能讓醫師快速驗證與校正模型邏輯,在維持診斷精準度的同時顯著縮短作業時間,為臨床工作流程與醫學研究帶來重大進展。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1自動生成結構化 CT 診斷報告,涵蓋胸腔與腹腔 60 多種解剖學異常。
- 2進行互動式多輪診斷問答,解答臨床研究員對於特定切片與病灶的追問。
- 3作為基礎模型供醫療機構或工作流程廠商使用自有 CT 資料集進行微調。
限制與注意事項
- 該模型為開源研發基礎,非自主診斷系統,亦未獲得臨床醫療器材許可。
- 影像輸入需重新取樣至 192³ 體素(2 mm 等向性解析度),可能限制對微小病灶的偵測。
延伸閱讀
不需重新訓練!PoEM 演算法直接預測新獎勵函數的強化學習結果
PoEM: Predicting RL Outcomes Without Re-training Existing Policies
PoEM 框架允許研究人員在不進行任何實際強化學習訓練的情況下,利用現有已對齊模型的對數空間線性組合,直接精準預測並合成適用於新獎勵函數的 AI 模型。
「誰對誰說了什麼?」SpeakerMem-R1 打造多方對話專屬的雙軌記憶機制
Who Said What to Whom? SpeakerMem-R1 Introduces Dual-Track Memory for Multi-Party Dialogues
針對多人對話中複雜的角色關係與脈絡,SpeakerMem-R1 透過標記說話者的「雙軌記憶」與 GRPO 強化學習,大幅提升長文本對話中的訊息歸屬與關係追蹤能力。
FleXray:首款通用型全身體檢 X 光影像分割模型
FleXray: Universal Generalist Model for Full-Body X-Ray Segmentation
FleXray 透過物理生成式資料引擎,利用 3D 電腦斷層(CT)資料模擬出具備標記的 2D X 光影像,成功實現能分割全身 60 種解剖結構的通用型 X 光分割模型。