雙金入袋!NVIDIA 透過微調 Nemotron 征服 2026 國際奧賽數理與資訊殿堂
Double Gold: Specializing NVIDIA Nemotron for IOI and IMO 2026
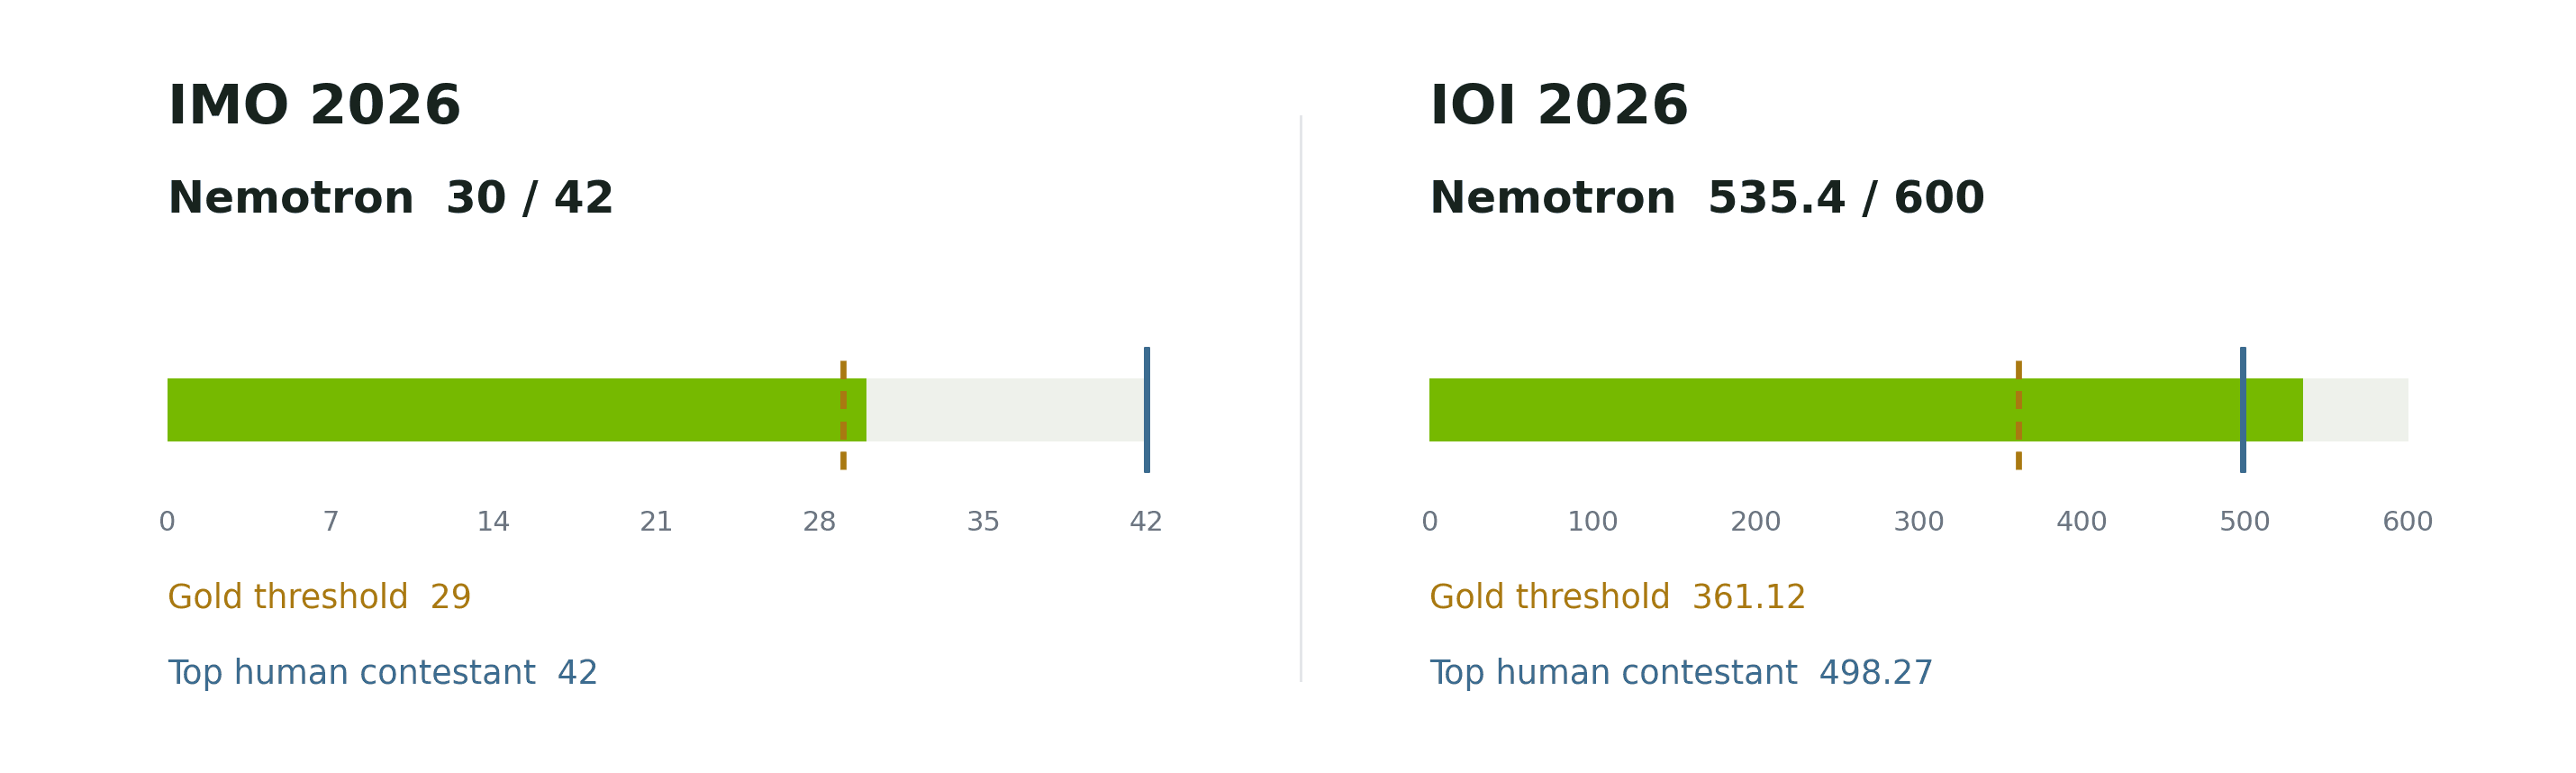
NVIDIA 團隊展示了如何透過一套四步驟的「微調與推理」配方,將 Nemotron-3 基礎模型打造成世界級的領域專家。在 IOI 2026 中,550B 參數的 Nemotron-3-Ultra-CC 獲得 535.4/600 高分,超越金牌門檻與人類最高分。在 IMO 2026 中,特化模型在無任何外部工具輔助下獲得 30/42 分,同樣跨越金牌門檻。團隊將微調、高質量資料集與測試時推理迴圈(如 GenCorrect)深度整合,並已將模型、資料集與推理程式碼開源。
核心重點
黃金微調配方
無需重頭訓練基礎模型,而是結合強大底座、領域資料、SFT/RL 微調,以及「生成-評估-精進」的推理迴圈。
規模化微調差異
對於 30B 的 Nano 模型,SFT 與 RL 的結合帶來顯著進步;而對於 550B 的 Ultra 模型,僅一輪 SFT 即超越了完全微調的 Nano 模型。
純自然語言數學推理
IMO 系統不依賴任何形式化證明器、外部工具或網路,完全透過模型間的自然語言生成、評分與自我修正來完成複雜論證。
測試時運算的協同設計
金牌級成績並非單靠微調,而是將微調後的專家模型與 GenCorrect 等測試時搜尋、驗證推理迴圈協同設計的成果。
技術圖解
| IOI 2026 (程式/資訊) | IMO 2026 (數學) | |
|---|---|---|
| 特化模型 | Nemotron-3-Ultra-CC (550B SFT) | Nemotron 3 Ultra (SFT 與 RL 組合) |
| 競賽成績 | 535.4 / 600 (金牌門檻 361.12) | 30 / 42 (金牌門檻 29) |
| 關鍵推理策略 | GenCorrect 多輪迭代修正迴圈 | 生成-驗證-重構 多模型協同審查 |
| 外部工具依賴 | 有(程式編譯與回饋) | 無(完全基於自然語言推理) |
為什麼重要
這項成果證明了開源/開放權重基礎模型不需要耗費天文數字重新訓練,只要透過結構化、可複現的微調與推理架構優化,就能在人類最頂尖的數理競賽中達到金牌水準。這為企業與研究人員提供了一套明確的領域特化指南(Specialization Recipe),有助於將 AI 應用於高複雜度的邏輯推理與軟體開發中。
對誰有影響
- AI 開發者
- AI 研究人員
- 產品經理
- 企業決策者
可以怎麼使用
- 1高難度程式開發與自動偵錯:利用 GenCorrect 的多輪「生成-評估-修正」機制,進行自動化軟體工程與複雜演算法開發。
- 2複雜邏輯與學術推理驗證:在數學、法律或金融等高精度領域,透過 SFT 與多模型自我審查機制生成並檢驗嚴謹論證。
限制與注意事項
- 非官方與非監督測試:IOI 成績為模擬真實競賽限制下的非官方測試,未列入正式官方排名。
- 高推理運算資源需求:金牌表現高度依賴推理階段的多輪搜尋與驗證(Test-time compute),這會顯著增加實際部署時的延遲與算力成本。
延伸閱讀
打造過目不忘的 3D 空間記憶:Ledger 如何透過第一人稱影片追蹤隱形物體
Building Persistent 3D Object Memory: How Ledger Tracks Objects from Egocentric Videos
普林斯頓等機構的研究人員提出 Ledger 框架,透過第一人稱視角影片為具身智慧助理建立持久的 3D 物體記憶,大幅提升空間定位與問答的準確度。
探索與優化解耦:全新強化學習框架 ExpDis 提升大語言模型的推理多元性
Decoupling Exploration from Optimization: How ExpDis Boosts LLM Reasoning and Solution Diversity
本研究提出 ExpDis 框架,將強化學習中的「探索」與「優化」解耦。透過訓練帶有新穎性獎勵的探索者模型,篩選正確解法並蒸餾至學生模型,解決了傳統 RLVR 因過度探索導致模型退化的難題。
去中心化 SGD 克服重尾雜訊:梯度裁剪如何實現最佳收斂與線性加速
Clipped Decentralized SGD: Achieving Optimal Convergence and Linear Speed-Up Under Heavy-Tailed Noise
本研究證明了在重尾雜訊下,採用梯度裁剪的去中心化 SGD(DSGD)能達到最佳收斂率,並在非凸優化中首次實現了隨節點數量增加的線性加速。