NVIDIA Topograph:實現拓撲感知排程,徹底釋放 AI 工廠 GPU 效能
Topology-Aware Workload Scheduling with NVIDIA Topograph
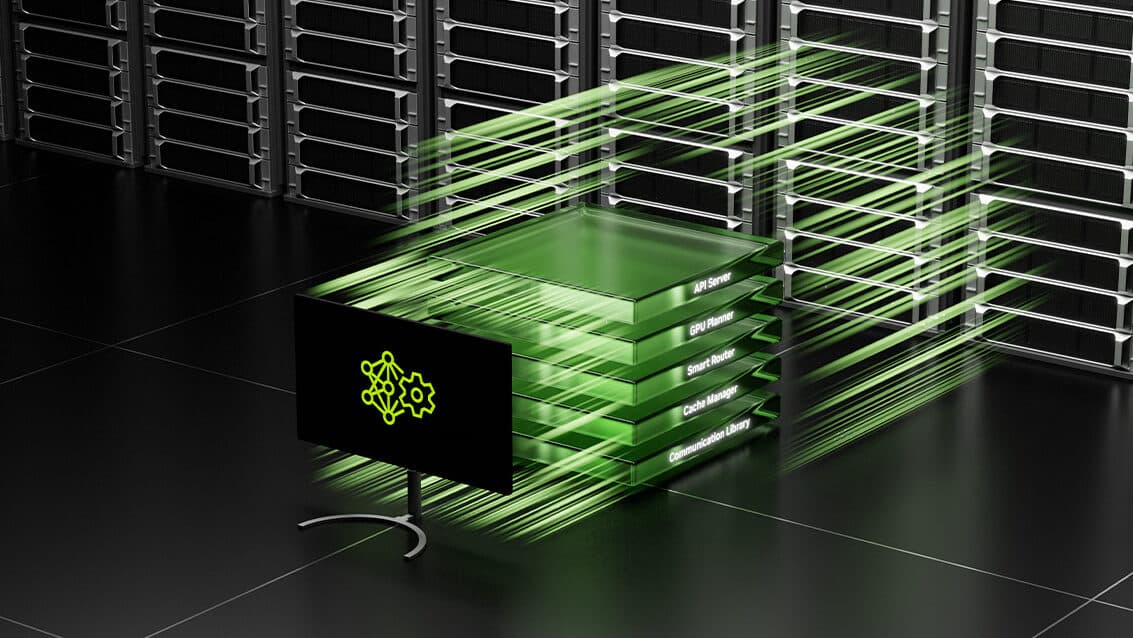
分散式 AI 任務極度依賴 GPU 間的高頻寬通訊。NVIDIA Topograph 解決了手動維護叢集拓撲資訊的痛點。它能從雲端 API 或地端 InfiniBand、Spectrum-X 等網路自動發現硬體連接關係,並動態產生 Kubernetes 節點標籤或 Slurm 拓撲設定檔。搭配 KAI Scheduler 或 Slinky,排程器能將緊密耦合的工作負載精準放置於實體距離最近(如同機架、同 NVLink 網域)的 GPU 節點中,避免網路擁塞並極大化運算效率。
核心重點
自動化拓撲發現
自動從雲端 API 或地端網路(如 InfiniBand、NetQ)查詢實體網路與硬體的連接狀態,免去手動維護拓撲圖的負擔。
多排程器引擎轉譯
將取得的拓撲數據標準化,並動態輸出為 Kubernetes 節點標籤、Slurm 設定檔或 Slinky ConfigMaps。
極大化 AI 工廠效率
使排程器能將緊密耦合的工作負載限制在高頻寬的 NVLink 網域內,防止因網路瓶頸導致 GPU 閒置消耗電能。
事件驅動動態更新
透過 Node Observer 監控叢集變化並即時重整拓撲視圖,內建延遲聚合機制,防止短時間內高頻重複運算。
技術圖解
為什麼重要
隨著 AI 模型規模呈指數級成長,由數萬顆 GPU 組成的「AI 工廠」面臨嚴重的電力與網路頻寬限制。若排程器隨機將運算任務分散在不同機架,將迫使大量資料跨越共享網路鏈結,導致嚴重的網路擁塞與 GPU 閒置。Topograph 提供精確的即時實體網路地圖,使 KAI Scheduler 等工具能實現「拓撲感知群組排程」,顯著提升每瓦代幣(tokens per watt)效率並降低訓練與推論的實體運作成本。
對誰有影響
- AI 開發者
- 企業決策者
- 產品經理
可以怎麼使用
- 1在 Kubernetes 叢集中結合 KAI Scheduler 或 Kueue,進行大語言模型(LLM)訓練與推論的拓撲感知群組排程。
- 2在地端大型 GPU 叢集中,自動將物理拓撲結構寫入 Slurm 設定檔以最佳化任務分配。
- 3透過 Slinky 在 Kubernetes 上運行 Slurm,並利用 ConfigMap 同步最新硬體拓撲關係。
限制與注意事項
- 高度依賴底層雲端服務商 API 或特定的網路管理工具(如 ibnetdiscover 或 NetQ)來提供拓撲資訊,若底層無法回報則無法運作。
- Topograph 反映的是已回報的實體連線狀況而非預期設計,物理變更的更新即時度受限於資料源的觸發機制。
延伸閱讀
Hugging Face 推出 @huggingface/kernels:為網頁端在地 AI 提供超過 200 個極速 WebGPU 核心
Hugging Face Launches @huggingface/kernels: Over 200 Optimized WebGPU Kernels for Local Web AI
Hugging Face 釋出開源庫 @huggingface/kernels 與 Fleet 瀏覽器測試套件,提供 207 個經優化的 WebGPU 算子,在 Apple M4 GPU 測試中比 ONNX Runtime Web 平均快 2.57 倍。