AI Daily ·
高效線性注意力與 AI 代理架構的技術突破
Today’s AI Highlights
今天的 AI 日報聚焦於模型效率與智慧代理的最新進展。在模型最佳化方面,STEPQuant 與 LeapQuant 透過創新的量化技術顯著壓縮線性注意力機制的記憶體並加速推論;而在代理架構方面,探討「Thinking Before Thinking」的中繼推理機制以及 NVIDIA 推出的 Kumo Tabular 表格預測開源基礎模型,全面提升 AI 系統在長文本執行與零樣本預測上的效能與運算效率。
- 01arXiv大型語言模型
STEPQuant:空間與時間雙重優化,突破線性注意力循環狀態量化瓶頸
線性注意力模型雖能以固定大小的「循環狀態」取代隨長度增長的 KV Cache,但在高併發伺服時,這些狀態仍會帶來龐大記憶體負擔。直接將其量化至低精度會導致誤差在遞迴更新中累積放大。為解決此問題,STEPQuant 框架從時間(分析記憶體存活期與誤差大小)與空間(結合鍵列與值行尺度分布)雙重維度出發,動態分配精度並進行聯合尺度擬合。實驗顯示,其在 6-bit 下能逼近 FP32 的精度,並已整合至 SGLang 實現 5 倍以上的狀態壓縮與顯著的記憶體節省。
- 02arXiv大型語言模型
LeapQuant:突破線性注意力瓶頸,實現近乎無損的 8-bit 遞迴狀態量化
隨著混合結構 LLM(如 GDN、KDA)逐漸採用線性注意力來壓縮長文本,頻繁讀寫遞迴狀態(Recurrent State)成為推論的主要瓶頸。量化雖能降低成本,卻容易因誤差累積與離群值(Outliers)造成模型精度大幅下降。LeapQuant 提出一種免訓練的 8-bit 量化方案:它採用「逐視窗量化」跳過頻繁更新以減少誤差累積,並將狀態中的極端離群值保留為高精度的「補償 Token」(Compensator Tokens),最後對剩餘殘差進行平滑化。在 Qwen、Kimi 與 GLM 等模型上的測試顯示,它在硬體上可達到 1.47 倍的端到端加速,且精度與 FP32 相當。
- 03arXivAI 研究
LIFT 架構:透過老師監督引入潛在資訊回饋,突破 Transformer 的單向限制
傳統 Transformer 的資訊流是單向的,僅能靠解碼出的 token 作為跨步驟傳遞的唯一管道。LIFT(潛在資訊回饋 Transformer)打破了這個限制。在預訓練期間,它利用現成預訓練模型的下一 token 分佈,為每個輸入 token 標註一個高密度的「資訊狀態」。模型被訓練成能同時預測下一個 token 與下一個狀態。推理時,模型會將自己預測的狀態回饋至輸入。實驗證實,135M 至 1B 參數的 LIFT 模型在推理、程序性任務上表現皆優於傳統 Transformer。
- 04arXivAI 代理
後設推理:讓 AI 代理在動手前先「思考如何思考」
隨著 AI Agent 執行的任務變得更長且更複雜,如何控制執行路徑成為一大挑戰。研究團隊提出「Agent 後設推理」(Agentic Meta-Reasoning)框架,將系統拆分為負責具體任務的「工作端」與負責高階決策的「控制器」。控制器不重播完整歷史,而是攜帶精簡摘要,評估剩餘預算與下一步方案,並自持久性記憶中提取脈絡指派任務。實驗顯示,此方法在長任務與高預算下能持續提升表現,解決了傳統直接控制方法的效能瓶頸。
- 05arXivAI 代理
以「後設技能」為核心的 AI4AI:為 Agent 設計最佳執行環境的測試期學習架構
傳統提升 Agent 表現多聚焦於增強其推理能力,本論文則從「環境建構」下手。在模型權重凍結的情況下,設計一個「建造者(Builder)」模型來為「目標(Target)」Agent 建構執行環境。研究引入「後設技能(Meta-Skill)」機制,讓建造者從目標 Agent 的執行回饋中總結出環境設計原則(何時提供支援、提供何種資源)。在 Harness-Bench 和 NewtonBench 測試中,此方法比無技能建構提升了 8.95%,且比直接將技能庫交給 Target 還要高出 12.02%。
- 06arXiv影片 AI
突破均勻分佈陷阱:透過 SplitMoE 解決影片擴散模型的擴展瓶頸
將大型語言模型中常用的混合專家模型(MoE)直接套用於影片生成時,會因強制將 Token 均勻分配給各個專家,進而割裂空間上連續的影片區塊,造成畫面失真。本研究提出的 SplitMoE 突破了此限制。它將專家池劃分為負責高階語意抽象的「語意專家」與保留底層視覺細節的「通用專家」,並結合原型引導路由與拉推正規化技術。在相同運算資源預算下,SplitMoE 能讓 Token 依據語意特徵自然聚集,顯著提升影片生成品質與收斂速度。
 07Hugging FaceAI 研究
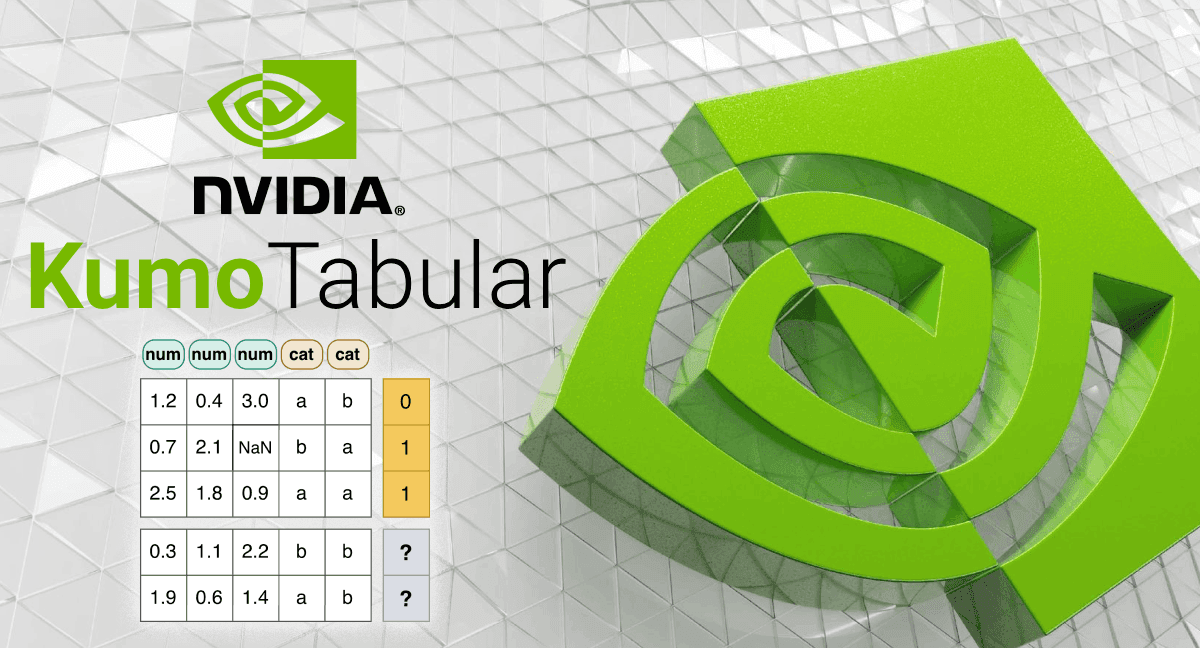
NVIDIA 推出 Kumo Tabular:免訓練、免微調的表格數據開源基礎模型
NVIDIA 發布的 Kumo Tabular 是一款針對表格資料的開源基礎模型(提供 28M 至 215M 三種尺寸)。它借鑑了 LLM 的上下文學習(In-context learning)概念,直接將有標籤的表格作為上下文輸入,即可為新數據進行預測。該模型完全使用基於結構因果模型(SCM)生成的虛擬數據進行預訓練,在 TabArena 等多個主流表格基準測試中名列第一,其推理速度比同類模型快上 17 倍。
 08NVIDIA Developer開源
打造 AI 原生專案:NVIDIA TensorRT Model Connect 的開發啟示
NVIDIA TensorRT Model Connect 是一個 C++ 開源專案,旨在簡化高效能推理。開發團隊沒有將 AI Agent 僅當作輔助工具,而是實踐「AI 原生設計」:將任務水平拆分、給予 Agent 明確目標與驗證標準(而非限制實作步驟),並實施嚴格的模型家族隔離與可逆變更。至 2026 年 7 月,該專案已支援並在 NVIDIA GB300 上測試了 128 個模型家族。
- 09arXiv機器人
技能空間射擊演算法:利用基礎模型引導機器人自主進行策略優化
傳統的機器人策略修正高度依賴人類手把手示範。本研究提出「技能空間射擊(Skill-Space Shooting)」機制,將常見的短動作定義為跨任務通用的「可重用技能」。當機器人在實體環境中遭遇失敗時,系統利用基礎模型引導,在這些技能空間中進行試探性搜尋(Shooting)以找出可行的修正方案,並將成功的嘗試轉化為訓練資料以優化控制策略,達成無需人類介入的自主學習。
- 10arXivAI 研究
Imagine3D-LLM:讓多模態大模型在回答前「腦補」出 3D 場景
傳統的多模態大模型(MLLM)在處理單張圖片時表現優異,但在整合多視角影像以進行 3D 空間推理時卻面臨挑戰。為了解決這個問題,南韓研究團隊提出 Imagine3D-LLM。該模型借鏡人類「先在大腦中重組粗糙 3D 佈局」的認知過程,在影像 Token 後方加入可學習的「摘要 Token」(summary tokens),並將其解碼為精簡的 3D Gaussian Splatting(3DGS)表徵。透過結合光度重建損失與傳統的下一個 Token 預測目標進行聯合訓練,該模型能有效在內部傳遞 3D 感知訊號,在多項 3D 理解基準測試中取得領先。