NVIDIA 於 KDD Cup 的實務經驗:打造可靠資料分析 Agent 的 Harness 設計原則
Building Reliable Data Analytics Agents: Lessons from NVIDIA's KDD Cup Harness Design
在 KDD Cup 資料 Agent 競賽中,團隊必須使用固定的小型 LLM,針對涵蓋資料庫、文字檔、PDF 與影片等異質資料進行複雜分析。NVIDIA KGMON 團隊將 CSV 和 JSON 統一匯入 SQLite 資料庫,並在主推論循環前加入 Schema Scout 預檢步驟。此外,他們限制 Agent 僅能呼叫少數專用工具,並利用持久化 Python 環境與軌跡檢驗機制,大幅降低除錯成本與工具誤用率。
核心重點
統一資料介面與 Schema 預檢
將異質 CSV/JSON 資料轉入 SQLite 統一 SQL 介面,並在分析開始前執行唯讀 Preflight 檢查資料表欄位與潛在 Join 鍵,節省初期探索輪數。
受限工具集與持久化執行環境
限制 Agent 僅能使用少數精準工具,並於持久 Python 環境中保留中間變數,搭配 Middleware 自動修復格式錯誤的呼叫。
上下文友善的文件與影片預處理
阻止 Agent 直接讀取大檔案,透過專用 prose_helper 與關鍵影格/逐字稿對齊工具,避免過多原始資料佔滿 LLM 的 Context Window。
軌跡審查與選擇性解答聚合
完整記錄 Prompt 與工具呼叫軌跡,由 Inspector Agent 進行失敗歸因;對高不確定性任務進行多次嘗試並聚合解答,確保輸出精確度。
技術圖解
為什麼重要
許多團隊在建構 AI Agent 時盲目追求更大的通用 LLM,但在企業情境中,算力與模型選擇常受限制。NVIDIA 的經驗證明,圍繞模型打造清晰、受限且可驗證的 Harness,比單純開放模型自由度更能帶來可靠的業務分析能力,為開源與小型 AI 模型落地提供實用藍圖。
對誰有影響
- AI 開發者
- AI 研究人員
- 產品經理
- 企業決策者
可以怎麼使用
- 1跨異質資料庫與非結構化文件的企業自動化資料分析
- 2基於小型開源 LLM 的輕量化特定領域 AI Agent 開發
- 3自動化 Agent 執行軌跡診斷與除錯系統建設
限制與注意事項
- 多次嘗試與解答聚合會增加 Token 消耗與延遲,需視任務價值選擇性採用。
- 影片預處理與表格自動抽取會增加前期系統架構的複雜度。
延伸閱讀
BrickBench:評測 AI Agent 進行文字導向積木設計的全新基準
BrickBench: Evaluating Agentic Text-Conditioned LEGO Design
BrickBench 是一個評估 AI Agent 文字導向 LEGO 積木設計能力的基準,搭配 BrickAgent 互動環境,測試 Agent 在物理可行性、語意對齊與設計品質上的表現。
RECAST:透過自適應證據路由,為 LLM 計算出正確的上下文
RECAST: Active Evidence Construction via Adaptive Routing and Computation
RECAST 是一種全新的 Agent 框架,將「證據建構」視為循序決策過程,透過輕量級 RouterLM 結合程式碼編譯與計算,主動為 LLM 產出精準答案所需的上下文,而非僅依靠傳統 RAG 的靜態相似度檢索。
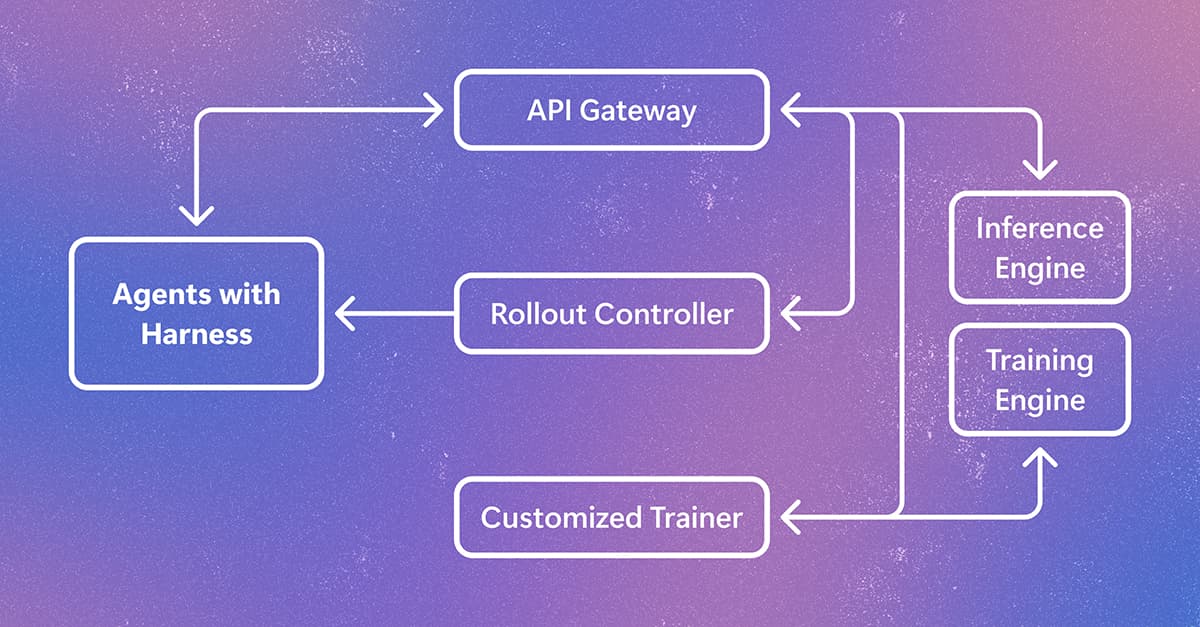
微軟開源 Agent Lightning v1.0:僅 3,500 行程式碼,直接用生產環境 Harness 訓練 Agent 的強化學習框架
Microsoft Releases Agent Lightning v1.0: A 3,500-Line Lightweight Agentic RL Framework for Real-Harness Training
微軟亞洲研究院推出 Agent Lightning v1.0,開創「Harnessed Agentic RL」架構,讓 AI Agent 訓練時能直接使用部署用的真實環境與工具套件,無須重寫程式碼即可進行高效強化學習。