NVIDIA Transformer Engine 加速生物基礎模型 MoE 訓練:吞吐量提升達 2.21 倍
Accelerating MoE Training for Biological Foundation Models with NVIDIA Transformer Engine
隨著生物學基礎模型規模擴大,混合專家模型(MoE)因能高效擴充參數而備受重視,但傳統實作常面臨 GPU 核心啟動開銷與記憶體瓶頸。NVIDIA 藉由 Transformer Engine 引入 GroupedLinear 整合專家運算,並利用 MXFP8 低精度訓練減少記憶體占用,最後透過 Sequential API 將線性轉換、SwiGLU 與路由權重縮放融合為單一 GroupedMLP 核心。在 8 顆 B200 GPU 測試中,此優化方案實現了高達 2.21 倍的訓練吞吐量。
核心重點
GroupedLinear 減少核心啟動開銷
使用 GroupedLinear 代替傳統 Python 迴圈,單次調用即可為多個專家提交 GEMM 運算,顯著降低 GPU 核心排程開銷。
MXFP8 低精度與區塊縮放
在 Blackwell GPU 上支援 MXFP8 訓練,每 32 個連續值共享一個縮放因子,在大幅節省記憶體的同時確保數值精準度。
融合 GroupedMLP 核心
透過 TE Sequential API 將量化、SwiGLU 活化函數與路由權重縮放融合,避免產生中間過渡資料,提升整體運算效率。
吞吐量顯著提升
在 8 顆 NVIDIA B200 GPU 的 Mixtral-8x7B 訓練基準測試中,吞吐量達到 Hugging Face 基準實作的 2.21 倍。
技術圖解
| Hugging Face Baseline | NVIDIA Transformer Engine (TE) | |
|---|---|---|
| 專家運算方式 | Python 迴圈依序啟動 (Naive loop) | GroupedLinear 批次提交 (Grouped GEMM) |
| 資料精度格式 | BF16 (16位元) | MXFP8 (8位元區塊縮放,適用於 Blackwell) |
| 核心優化方式 | 無融合,產生大量過渡資料 | 融合 GroupedMLP (融合量化、SwiGLU 與路由) |
| 訓練吞吐量基準 | 1.0x (基準點) | 高達 2.21x (在 8 顆 B200 GPU 上) |
為什麼重要
生物學基礎模型(如基因體學、蛋白質序列分析)通常面臨極長的序列與龐大的參數需求,傳統 Dense 模型訓練成本極高。雖然 MoE 能降低運算量,但若無軟硬體協同優化,專家分流會造成嚴重的 GPU 資源浪費。NVIDIA 提供的優化方案,讓生醫領域的 AI 研究人員能在 Blackwell 架構下高效訓練超大規模的生物學基礎模型,進而加速新藥研發與基因體學研究。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1訓練針對基因體學或蛋白質體學的大規模生物學基礎模型。
- 2在有限的 GPU 記憶體下,利用專家平行(EP)與 FSDP 訓練百億參數級的 Mixtral MoE 模型。
限制與注意事項
- 融合 MXFP8 GroupedMLP 核心需要特定的 NVIDIA Blackwell 架構 GPU 才能啟用硬體加速。
- 進行 MoE 訓練時,需要至少 2 顆 GPU 來實作專家平行(EP),不適用於單卡開發環境。
延伸閱讀
微創型語言模型導向技術:利用 MISVO 在不損害生成品質下優化輸出
Minimally Invasive Steering of LMs: Optimizing Rewards Without Quality Degradation
本研究提出 MISVO 技術,利用局部 KL 幾何(Fisher 二次式)懲罰過度干預,在不更新模型參數的前提下引導語言模型,能在維持生成多樣性與連貫性的同時提升獎勵分數。
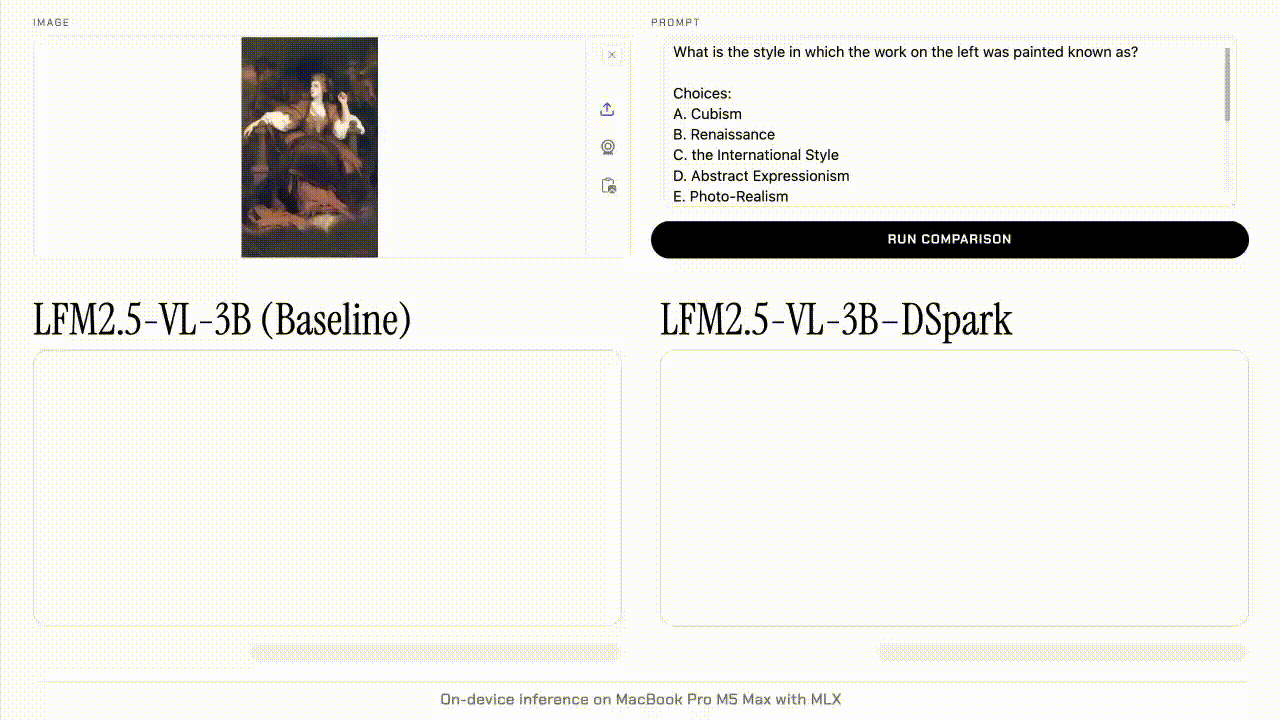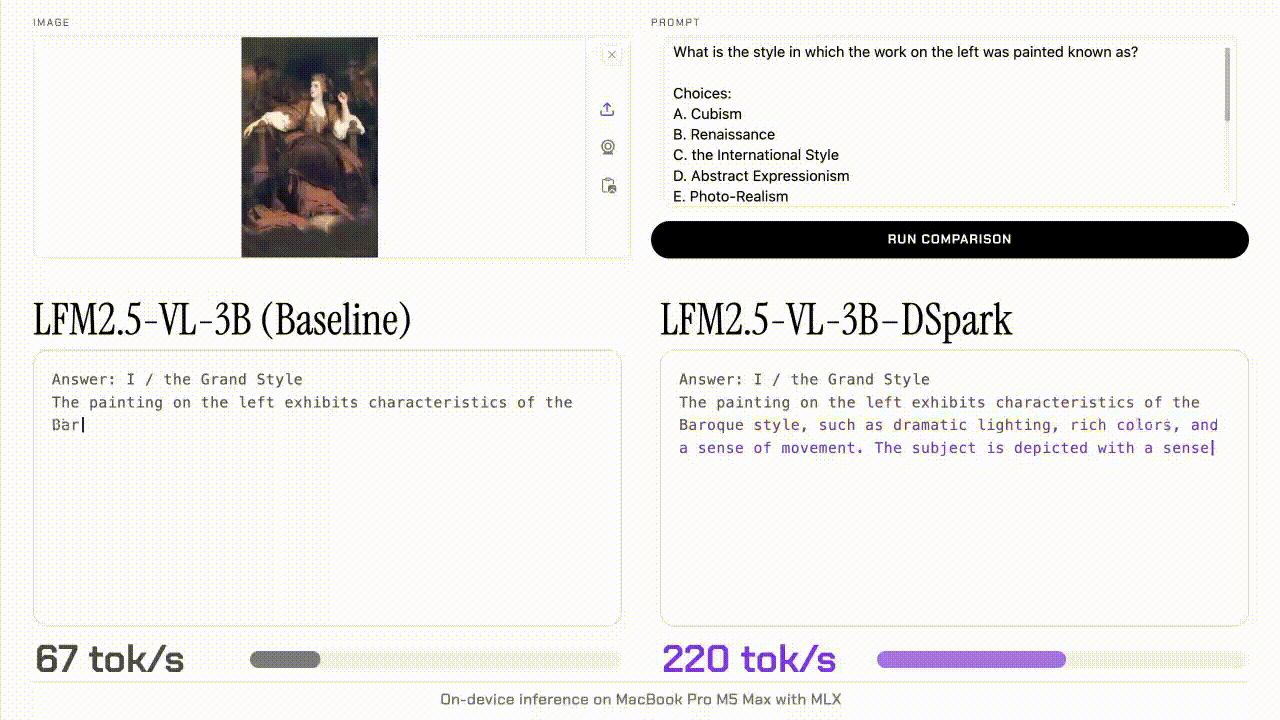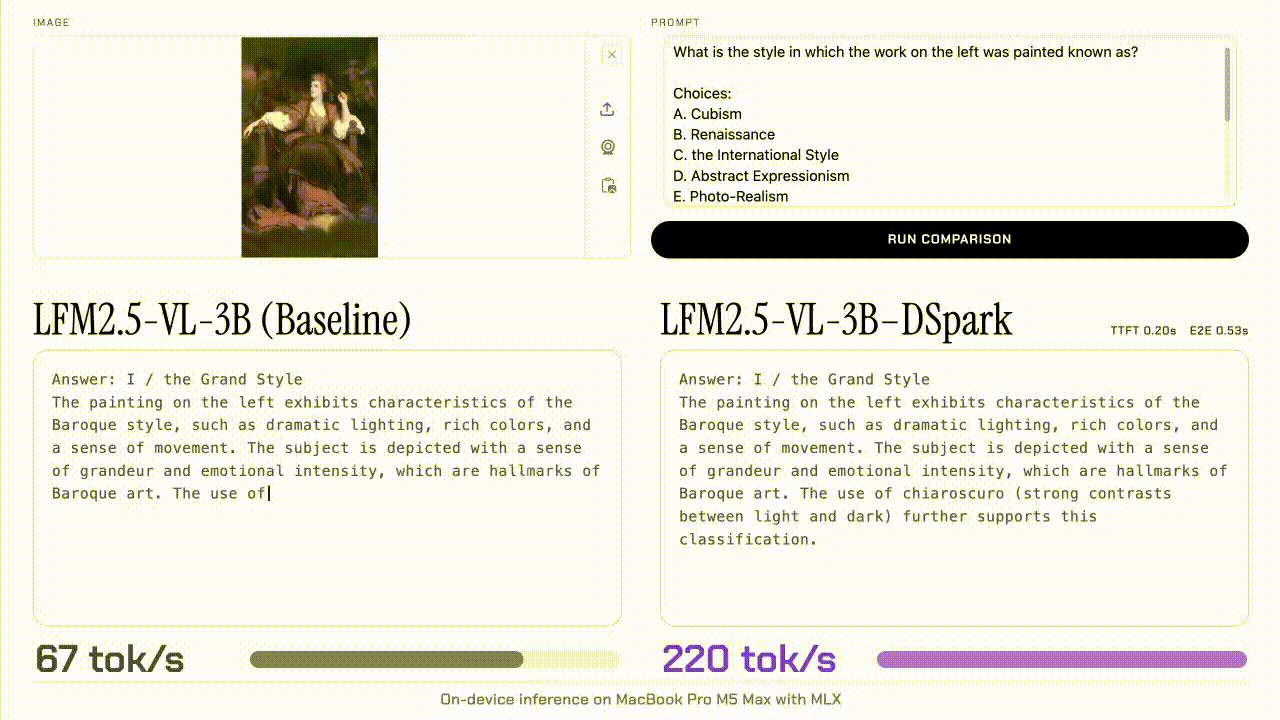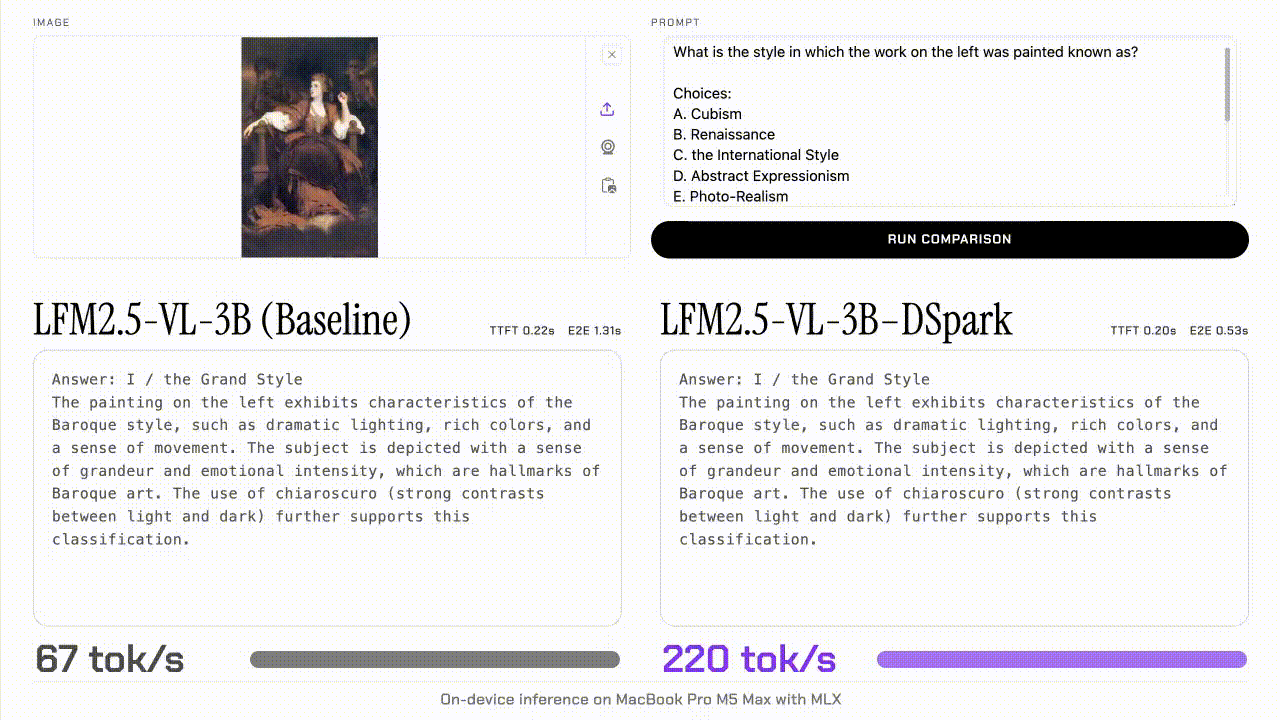
LFM2.5-VL-DSpark:以超低開銷將多模態模型推論速度提升達 3 倍
LFM2.5-VL-DSpark: Accelerating Vision-Language Models with Minimal Overhead
Liquid AI 針對 LFM2.5-VL-3B 模型推出僅 2.8 億參數的 DSpark 草稿模型,可在不犧牲準確度的前提下,將邊緣裝置與 GPU 的解碼速度提升高達 3.13 倍。
以 MaxText 重現 OLMo 3 7B 預訓練:Google Cloud TPU 大規模訓練實戰指南
Reproducing OLMo 3 7B Pre-training in MaxText: A Case Study of Large-Scale Training on TPUs
本文詳述如何使用 JAX 驅動的 MaxText 框架,在 Google Cloud TPU 上成功重現 AI2 開源模型 OLMo 3 7B 的預訓練與中期訓練階段,並分享效能最佳化與偵錯經驗。