以 MaxText 重現 OLMo 3 7B 預訓練:Google Cloud TPU 大規模訓練實戰指南
Reproducing OLMo 3 7B Pre-training in MaxText: A Case Study of Large-Scale Training on TPUs
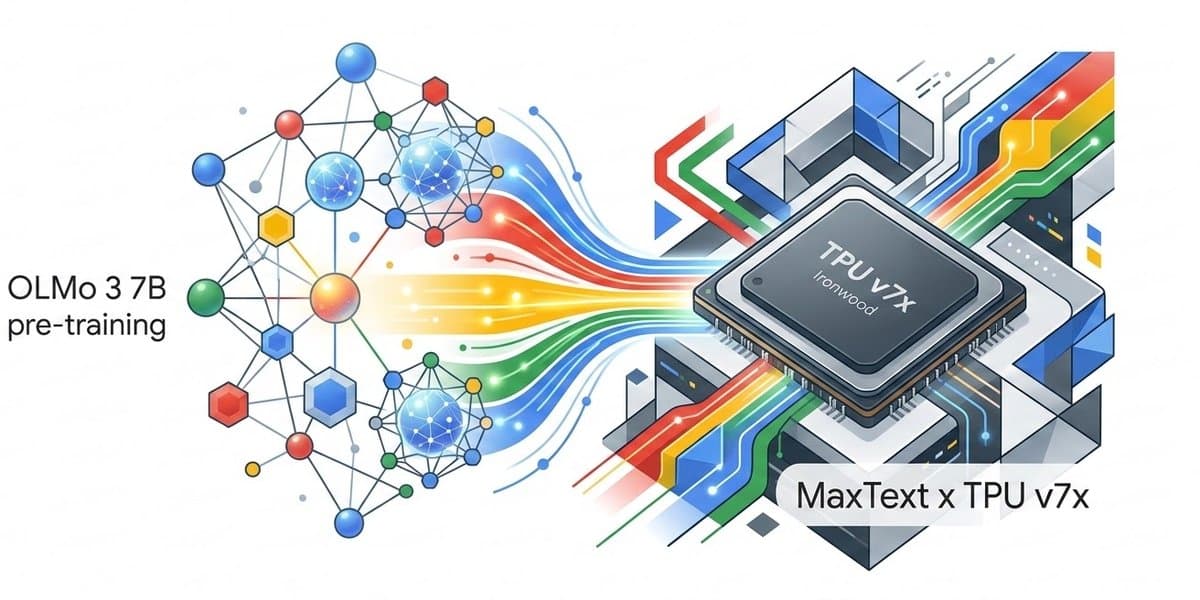
Google 團隊利用 MaxText 框架在 Cloud TPU 上,從零開始重現了 AI2 的 OLMo 3 7B 模型(包含 5.93T 標記的第一階段預訓練與 100B 標記的第二階段退火訓練)。研究團隊不僅使訓練損失曲線與 PyTorch/GPU 基準完美貼合,更在下游評估任務(如 MMLU、GSM8K)上達到幾乎一致的泛化效能。過程中克服了資料載入器的雙重分片錯誤(Grain bug)與優化器精度陷阱,並透過調整 Attention Head-dim 釋放了 TPU 硬體 12.4% 的額外吞吐量。
核心重點
評估指標完美對齊
不僅訓練損失曲線高度重合,在 MMLU、GSM8K 等多個下游任務的精度差距亦小於 ±0.005,證明 MaxText 與 TPU 堆疊的忠實度。
揭露偽裝成效能提昇的資料 Bug
資料載入器(Grain)雙重分片導致部分資料被重複訓練,使得訓練損失異常下降,但依靠「留出法評估」成功揪出這起非泛化性的過擬合。
調整 Head-dim 釋放 12.4% 算力
將 32 heads x 128 dim 改為 16 heads x 256 dim,完美契合 TPU 的 256x256 矩陣乘法單元,在不改變參數下提昇運算吞吐量。
架構與硬體移植彈性
JAX/XLA 使訓練配方與硬體拓撲解耦。第一階段運行於 Ironwood,第二階段無縫切換至 TPU v5p,且保持精準的斷點續訓與狀態還原。
技術圖解
| 原生配置 (Stock Variant) | MXU 優化配置 (Optimized Variant) | |
|---|---|---|
| 查詢標頭數 (Query Heads) | 32 | 16 |
| 標頭維度 (Head Dim) | 128 | 256 |
| TPU 矩陣乘法單元對齊 | 未對齊 (50% 陣列閒置) | 完美對齊 (防止閒置週期) |
| 硬體運算吞吐量 | 508 TFLOP/s/device (44.2% MFU) | 571 TFLOP/s/device (49.6% MFU) |
| 模型參數與運算量 | 完全一致 (7.298B Params / 1565 TFLOPs) | 完全一致 (7.298B Params / 1565 TFLOPs) |
為什麼重要
許多大型模型訓練宣稱「成功重現」,但往往僅流於訓練損失曲線的相似。本研究提供了一個極具價值的實戰案例,證明從 PyTorch/GPU 遷移至 JAX/TPU 時,必須透過獨立的「留出資料集評估」才能驗證框架的真實忠實度。此外,硬體協同設計(如 MXU 對齊)與正確的優化器精度設定(Adam 保持 float32)對大規模訓練的成敗至關重要,為開源社群提供了寶貴的調校經驗。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1在 Google Cloud TPU 上使用 MaxText 開源框架從頭預訓練或微調類 LLaMA 或 OLMo 的大語言模型。
- 2在易受搶佔的 TPU 叢集中配置斷點續訓,使用 Grain 確保中斷後能精確重啟資料迭代器狀態。
- 3針對特定的 AI 晶片(如 TPU MXU)調整 Attention 結構維度,在維持參數總量不變的前提下提高硬體運算效率。
限制與注意事項
- 在第二階段中期訓練的早期(前 8k 步),由於資料隨機打亂洗牌的差異,兩組模型訓練依然存在微小的初始資料分佈偏差。
- 必須維持 Adam 優化器狀態為 float32,若誤設為 bfloat16 會因精度遺失而導致訓練損失(loss)大幅攀升 0.93 左右。
延伸閱讀
微創型語言模型導向技術:利用 MISVO 在不損害生成品質下優化輸出
Minimally Invasive Steering of LMs: Optimizing Rewards Without Quality Degradation
本研究提出 MISVO 技術,利用局部 KL 幾何(Fisher 二次式)懲罰過度干預,在不更新模型參數的前提下引導語言模型,能在維持生成多樣性與連貫性的同時提升獎勵分數。
NVIDIA Transformer Engine 加速生物基礎模型 MoE 訓練:吞吐量提升達 2.21 倍
Accelerating MoE Training for Biological Foundation Models with NVIDIA Transformer Engine
本文介紹如何利用 NVIDIA BioNeMo 與 Transformer Engine 的優化算子,克服混合專家模型(MoE)在生物學應用中的訓練瓶頸,將訓練吞吐量提升至 2.21 倍。
LFM2.5-VL-DSpark:以超低開銷將多模態模型推論速度提升達 3 倍
LFM2.5-VL-DSpark: Accelerating Vision-Language Models with Minimal Overhead
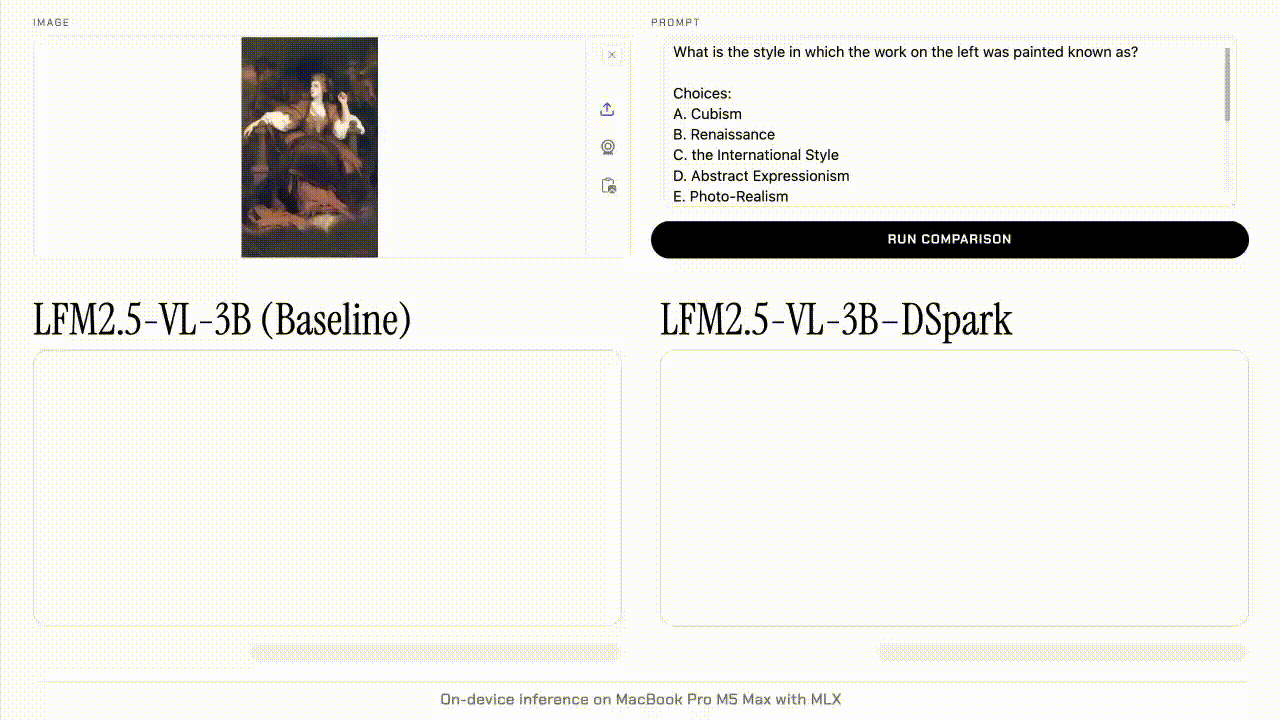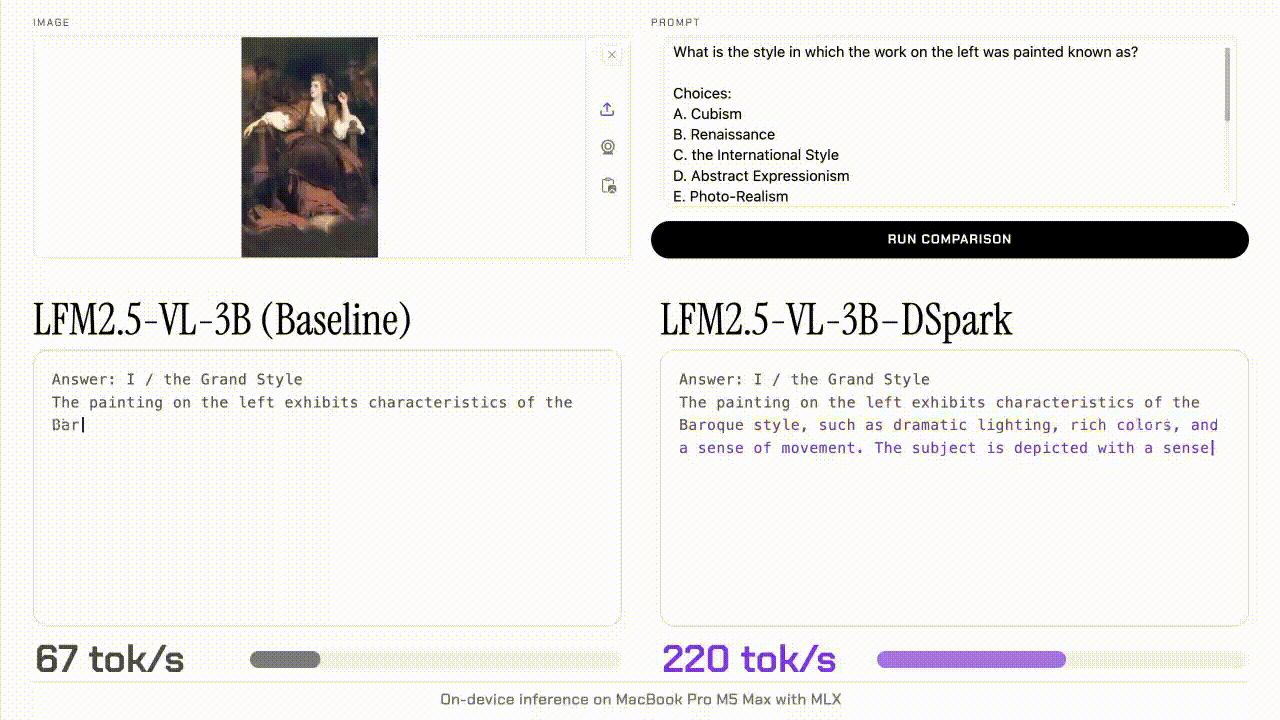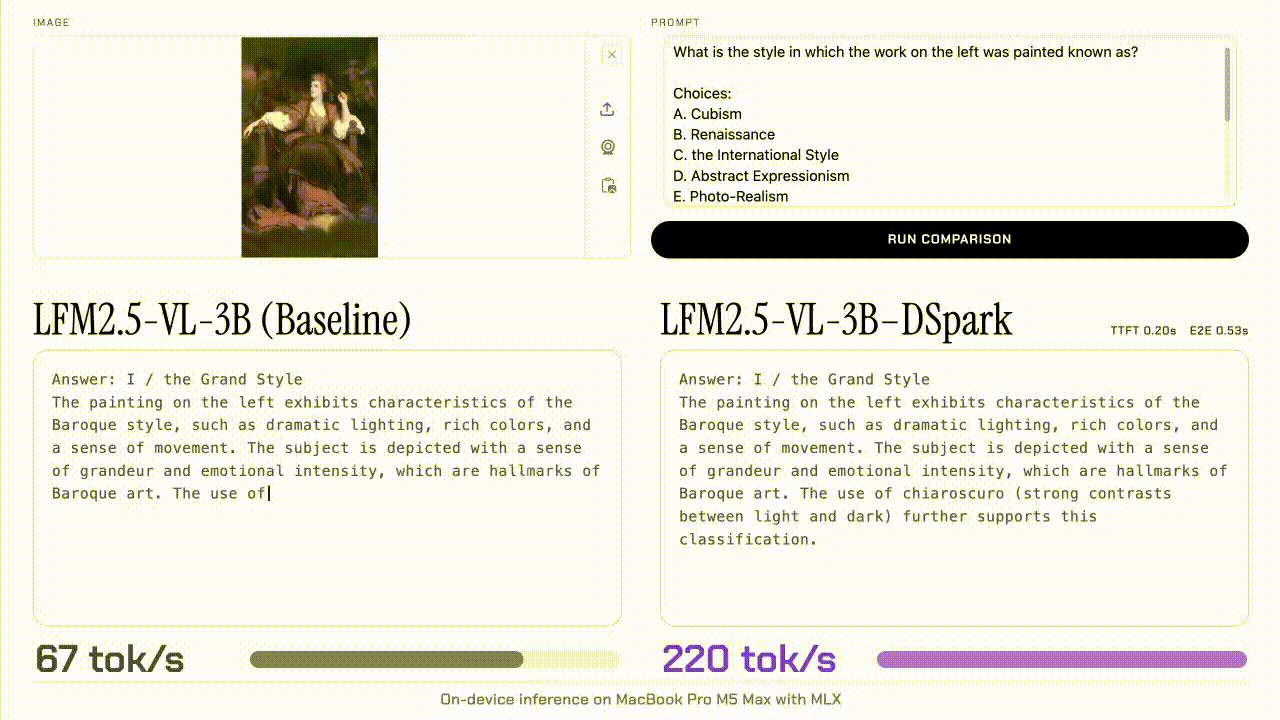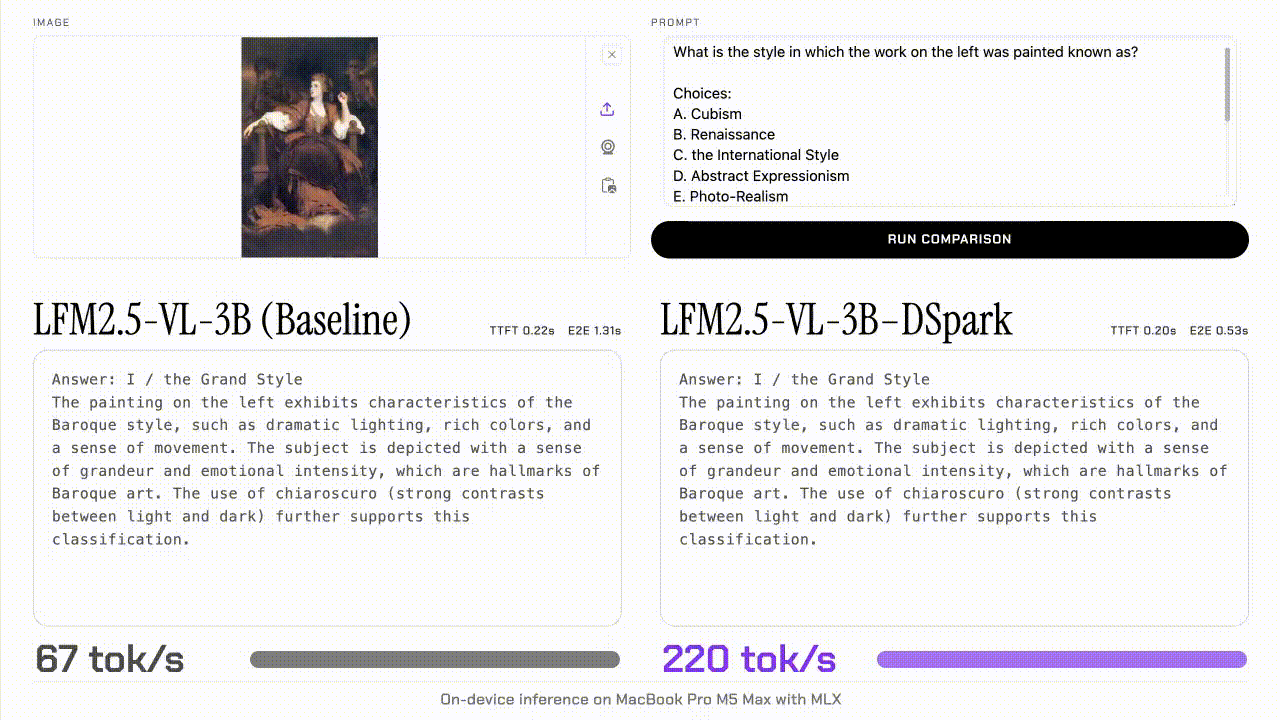
Liquid AI 針對 LFM2.5-VL-3B 模型推出僅 2.8 億參數的 DSpark 草稿模型,可在不犧牲準確度的前提下,將邊緣裝置與 GPU 的解碼速度提升高達 3.13 倍。