NVIDIA 推出 cuObject 與 SCADA 伺服器 SDK:實現免經 CPU 的 GPU 直連快取與物件儲存加速
NVIDIA Expands AI Storage Acceleration with cuObject and SCADA Server SDK
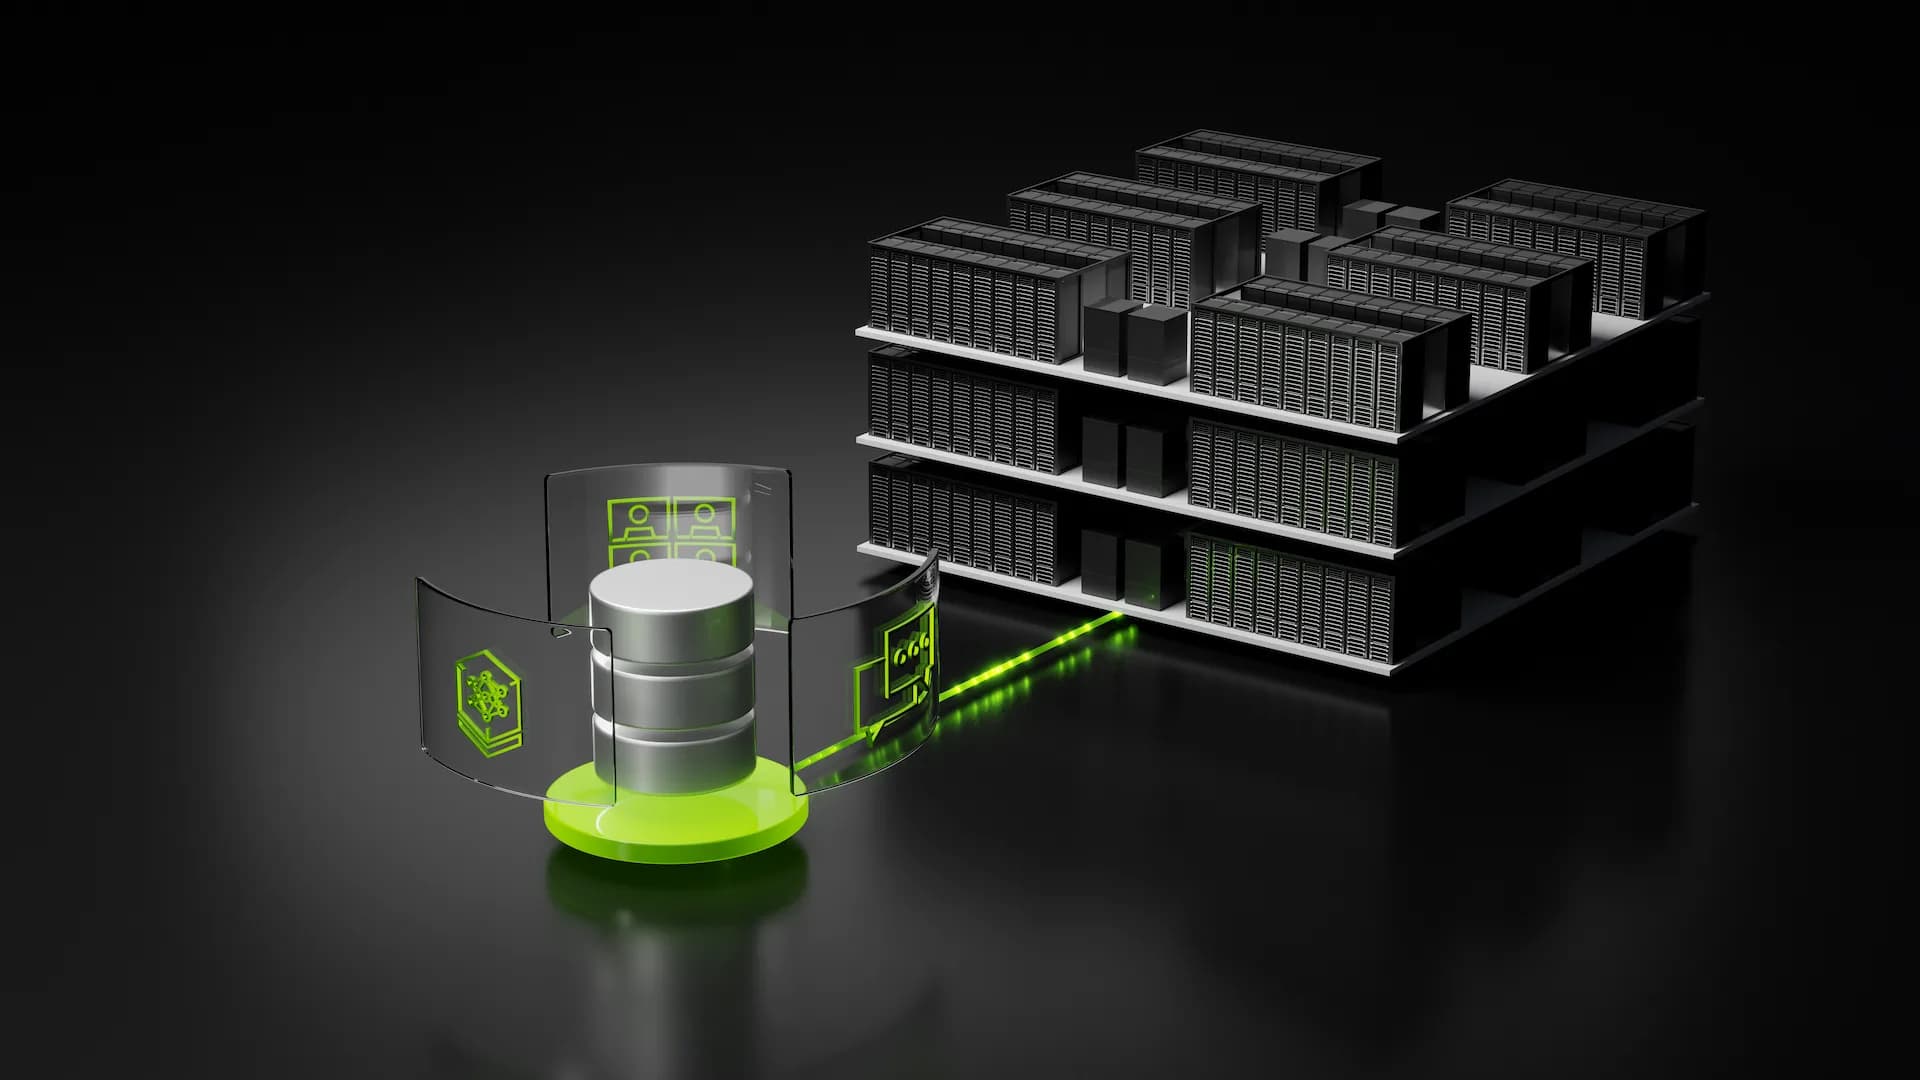
隨著 AI 模型與資料量暴增,傳統經由 CPU 複製資料的模式已成為效能瓶頸。NVIDIA 擴大開源組織 xio-sig,納入全新 cuObject 規範,並推出 SCADA 伺服器 SDK。這兩項技術讓 GPU 能直接透過 RDMA 與 DPU/NIC 技術,跨過 CPU 記憶體直接讀寫檔案與物件儲存(Object Storage)。IBM 已成功展示基於 SCADA 的儲存原型,而 Google Cloud 與 Microsoft 也計畫加入委員會,共同為高效能 AI 基礎設施建立統一的開放標準。
核心重點
cuObject 正式推出
NVIDIA 將 cuObject 納入 xio-sig 組織,提供統一的 API 與 RDMA 傳輸協定,讓 GPU 能直接加速存取物件儲存。
SCADA 伺服器 SDK
針對微小且細緻的 GPU 直接 I/O 請求提供全新軟體架構,讓儲存廠商能構建高效應答的 SCADA 伺服器。
零複製免經 CPU 傳輸
利用 DPU 或 ConnectX 網卡進行 RDMA 加速,資料無需經過主機 CPU 記憶體,有效降低延遲並釋放 CPU 運算資源。
跨產業開放標準生態系
透過 Storage-Next 倡議,獲得 Google Cloud、Microsoft、IBM 等超過 40 家廠商支持,建立互通的 AI 儲存標準。
技術圖解
為什麼重要
傳統儲存協定難以應付現代大語言模型(LLM)與 RAG 系統所需的高速、碎片化資料檢索。cuObject 與 SCADA 的推出打破了各家儲存廠商 API 不相容的壁壘,透過免經 CPU 的 GPU 直連技術(GPU-initiated storage),為語意搜尋、推薦系統及大規模 AI 訓練掃清 I/O 瓶頸,極大化硬體投資報酬率。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1大規模 AI 模型的訓練與微調(Fine-tuning)資料高速載入。
- 2語意搜尋與檢索增強生成(RAG)中的細粒度向量資料庫查詢。
- 3推薦系統與詐欺偵測中的高吞吐量、低延遲資料擷取。
限制與注意事項
- 需依賴支援 RDMA 的硬體設備(如 NVIDIA ConnectX 網卡或 BlueField DPU),企業升級初期硬體成本較高。
- 目前部分治理文件與核心程式碼仍處於合規測試與審查階段,尚未完全開源釋出。
延伸閱讀
破解電力瓶頸:NVIDIA DSX MaxLPS 如何釋放 AI 工廠高達 40% 的隱形算力
Unlocking Stranded Capacity: How NVIDIA DSX MaxLPS Boosts AI Factory Throughput by 49%
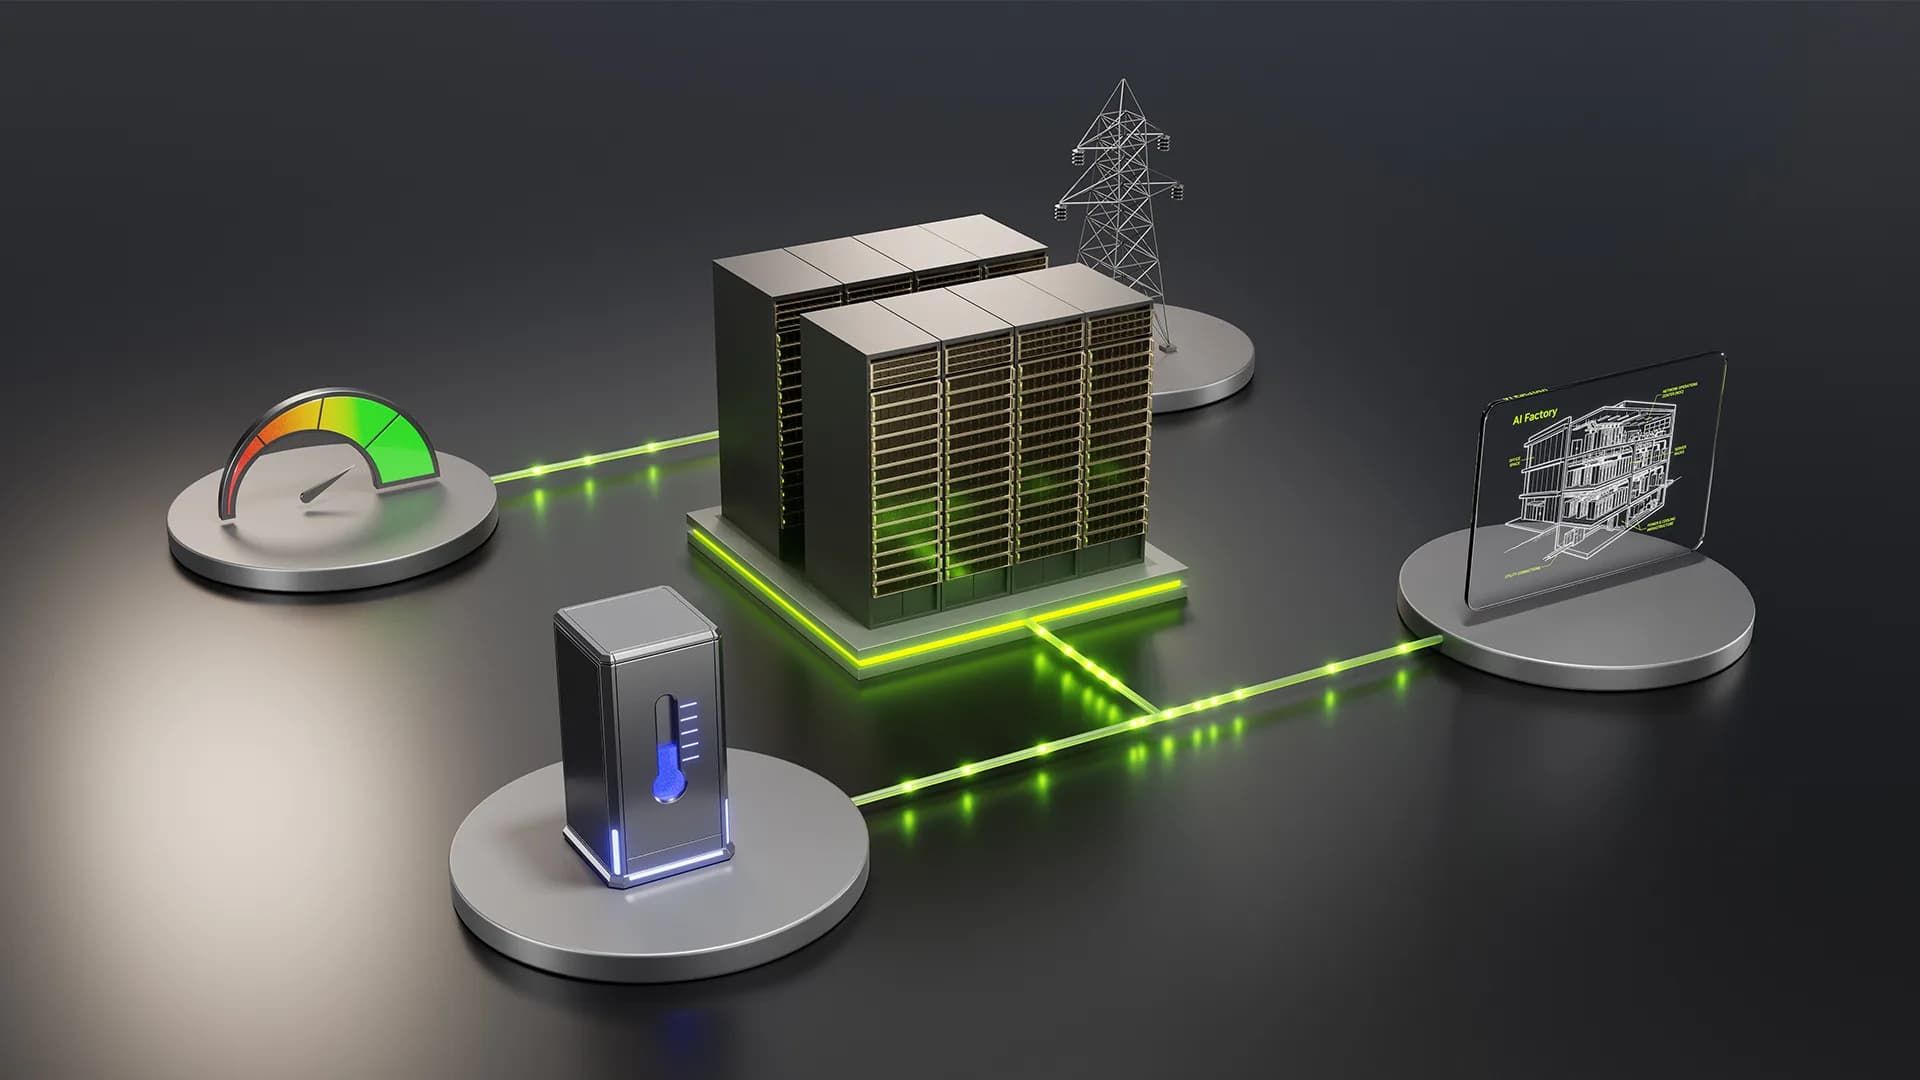
NVIDIA 與 Nscale 合作評估顯示,DSX MaxLPS 藉由動態調整 GPU 電力限制,能讓同等電力預算下部署的 GPU 數量增加 37%,並使 LLM 推理吞吐量提升 49%。
NVIDIA 開源 NVCRE:在 AI 工作負載上線前,自動驗證 GPU 叢集準備狀態
NVIDIA Launches Open-Source NVCRE: Automating GPU Cluster Readiness Validation Before AI Workloads Run
傳統的 GPU 健全狀況檢查常漏掉分散式訓練中的效能瓶頸。NVIDIA 開源的 NVCRE 是一款 Kubernetes 控制器,透過主動執行分散式測試工作負載,在生產部署前精準找出故障與效能退化的節點。
突破機密運算效能瓶頸:NVIDIA Blackwell 與 TensorRT-LLM 的隱私推理優化
Overcoming Confidential Computing Overheads: Optimizing Private LLM Inference on NVIDIA Blackwell
本文介紹 NVIDIA 如何透過 TensorRT-LLM 的架構級優化,在 B200 GPU 的機密運算環境下執行 DeepSeek-R1 推理,成功保留高達 98% 的吞吐量並控制延遲開銷。