解決 AI 評測重現難題:UK AISI 與 EvalEval 聯手推動基準測試標準化
Solving the AI Evaluation Reproducibility Crisis: UK AISI and EvalEval Partner for Standardized Benchmarks
隨著 AI 快速發展,評測基準百家爭鳴,卻常因格式不一、缺乏配置資訊而難以重現。為此,UK AISI 與 EvalEval 深度合作,將 AISI 的評測方法與發現整合至「Evaluation Cards」平台。此次釋出包含 HealthBench 與 FrontierMath 等五大基準測試,涵蓋 Claude Opus 4 及 GPT-5 等系列前沿模型,並展示了推論運算(inference-time compute)與評測協定如何影響模型表現。
核心重點
統一評測報告標準
推出「Every Eval Ever」(EEE)共享綱要,將零散的評測結果與詮釋資訊整合至統一的「Evaluation Cards」結構中。
高透明度的執行紀錄
強調對話文本級(transcript-level)透明度,這對於分析、診斷模型行為以及確保評測的可重現性至關重要。
推論運算與協定的影響
AISI 研究指出,前沿模型的基準測試表現(如 Humanity's Last Exam)會因推論時間運算量與評測協定而有顯著差異。
開放驗證參考數據
釋出包含 HealthBench、FrontierMath 等五大基準測試的驗證數據,涵蓋 Claude Opus 4 及 GPT-5 系列等 6 款前沿模型。
技術圖解
為什麼重要
當前的 AI 評測缺乏統一標準,使大眾難以判斷兩個相似分數是否是在完全不同的測試條件下產生的。透過 EEE 標準與 Evaluation Cards 平台,政策制定者、研究人員和開發者能精準比對不同實驗,避免因重做高昂測試而浪費資源。這為 AI 治理和科學化的安全評估奠定了可靠的互操作性基礎。
對誰有影響
- AI 研究人員
- 政策制定者
- AI 開發者
- 企業決策者
可以怎麼使用
- 1AI 元研究與分析:政策與治理研究員利用 Evaluation Cards 跨平台比對不同模型的安全表現,理解不同測試設定對結果的影響。
- 2標準化基準測試發布:評測開發者使用 Every Eval Ever 格式發表新基準測試,確保社群能完整重現其實驗配置。
限制與注意事項
- 目前僅深度發布了五個主要基準測試(如 HealthBench、FrontierMath 等)及兩項網路安全評估的驗證數據。
- 該生態系統的成功高度依賴模型開發商、評測機構與研究人員主動改用 EEE 綱要。
延伸閱讀
壓縮足跡化身安全訊號:利用破壞性壓縮抵禦聯邦學習中的模型投毒攻擊
Compression Footprints as Security Signals: Defending Federated Learning Against Model Poisoning
本研究提出 CRAFT 聚合防禦方法,將聯邦學習中常見的破壞性壓縮誤差轉化為安全特徵,在不增加額外通訊成本下,精準識別並過濾惡意投毒更新。
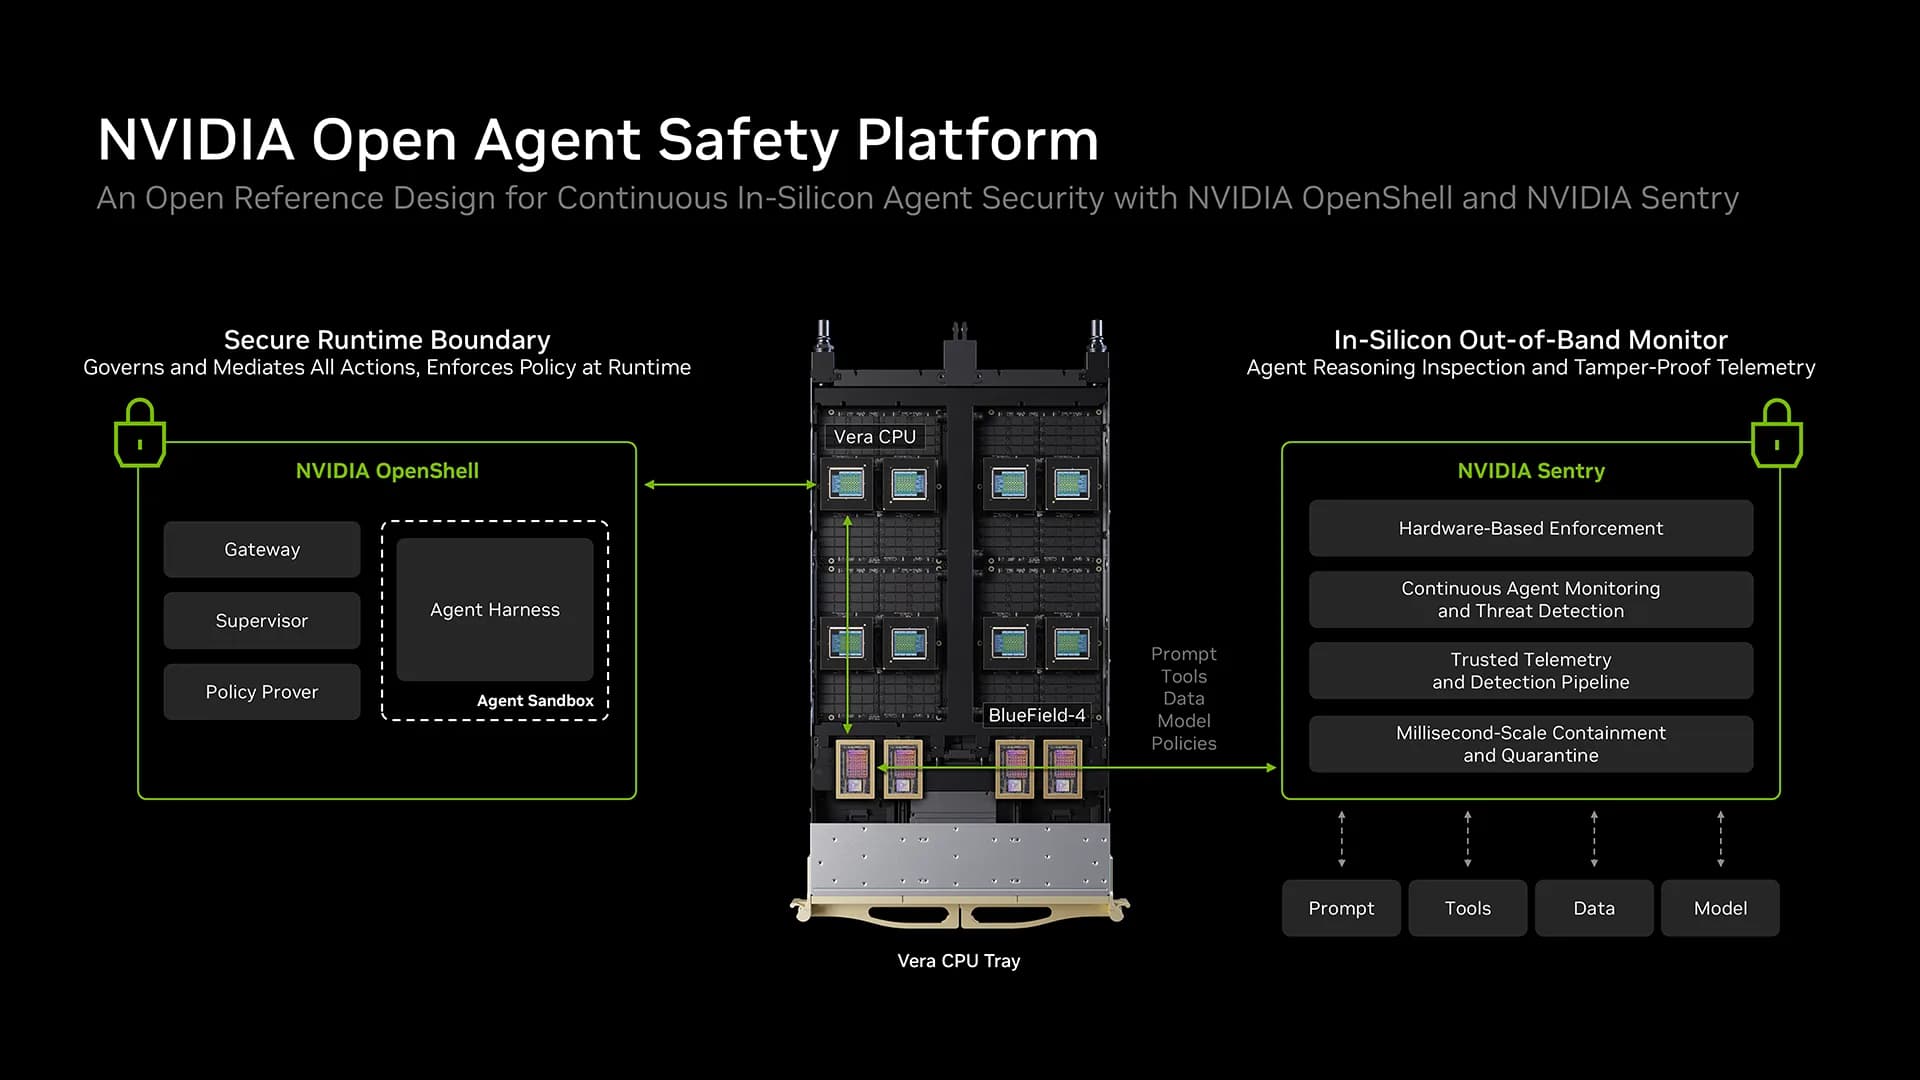
NVIDIA 推出 Open Agent Safety Platform:基於晶片與開源沙盒的 AI Agent 持續安全監控架構
NVIDIA Launches Open Agent Safety Platform for Continuous In-Silicon Agent Monitoring
為防範 AI Agent 脫逃與失控風險,NVIDIA 推出開源的 Open Agent Safety Platform,整合 OpenShell 沙盒與 BlueField DPU 硬體防護,提供獨立於 Agent 之外的零信任帶外監控與即時阻斷機制。
NVIDIA OpenShell:不重寫程式碼,為 AI Agent 部署執行階段安全隔離防護
NVIDIA OpenShell: Enforcing Secure Runtime Controls and Sandboxing for AI Agents
NVIDIA 開源 OpenShell 0.1.0 執行階段,在不更動既有程式碼的情況下,透過沙盒與外部監管器嚴格控管 AI Agent 的檔案存取、網路流量與敏感憑證。