KaliBench:首個 Kali Linux 資安工具指令生成基準測試,助 8B 模型直逼 685B 巨獸
KaliBench: Evaluating and Boosting LLM Command Generation on Kali Linux
在資安自動化中,LLM 需要將分析師意圖精確轉譯成不容出錯的終端機命令。KaliBench 填補了這一評測空白,包含 8,504 個自然語言對 CLI 命令的配對,涵蓋 1,642 個 Kali Linux 工具。測試結果顯示,開源大模型在無提示時的命令精確度普遍極低(均低於 42%)。為了優化此能力,KaliBench 設計了多階段驗證管道,並提供「免執行期可驗證獎勵」,讓 8B 小模型能以低成本進行強化學習,最終展現出比肩 685B MoE 旗艦模型的操作水準。
核心重點
精確 CLI 翻譯
專注於評估 LLM 能否生成完全無語法、參數或順序錯誤的實用 Kali Linux 命令。
大規模實戰資料
提供 8,504 個查詢與命令配對,橫跨 1,642 種資安工具、23 個能力維度與 5 大安全階段。
多階段驗證機制
整合 LLM 驗證、沙盒終端機執行與人工審查,確保測試集資料在語義與實務上完全可行。
免執行期可驗證獎勵
提供確定性的驗證訊號,免去繁重的動態執行環境,大幅降低模型進行 RL 強化學習的成本。
技術圖解
| 一般開源模型 (Open-Weight) | KaliBench 訓練後 8B 模型 | 685B MoE 旗艦模型 | |
|---|---|---|---|
| 指令準確度 | 低於 42% (無提示) | 顯著提升並媲美 MoE | 基準測試最高水平 |
| 硬體與推論成本 | 中等 | 極低 (8B 規模) | 極高 (685B 規模) |
| RL 訓練優化途徑 | 缺乏標準反饋訊號 | 免執行期可驗證獎勵 | 訓練極度昂貴 |
為什麼重要
在真實的 SecOps 或紅隊演練中,任何一個參數或旗標(flag)錯誤都會導致自動化流程中斷。KaliBench 不僅暴露了現行大模型在命令執行上的短板(準確率低於 42%),更提供了一種突破性的低成本訓練機制。資安團隊與企業能以此將 8B 級別的小型模型訓練成具備專家級工具調度能力的專屬 Agent,無須負擔 685B 等巨型模型的龐大算力成本,加速資安自動化落地。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
可以怎麼使用
- 1自主資安運營(SecOps)與自動化滲透測試 Agent 訓練
- 2資安專用大模型(Security LLM)的精確命令翻譯評測
- 3無動態執行環境下的低成本大模型強化學習(RL)
限制與注意事項
- 評測範疇限於 Kali Linux 工具鏈,對其他非 Debian 系統或非預裝工具的適應性尚未驗證。
- 目前聚焦於單步自然語言到 CLI 指令的翻譯,尚未完整涵蓋多步驟、具狀態相依性的複雜鏈式攻擊。
延伸閱讀
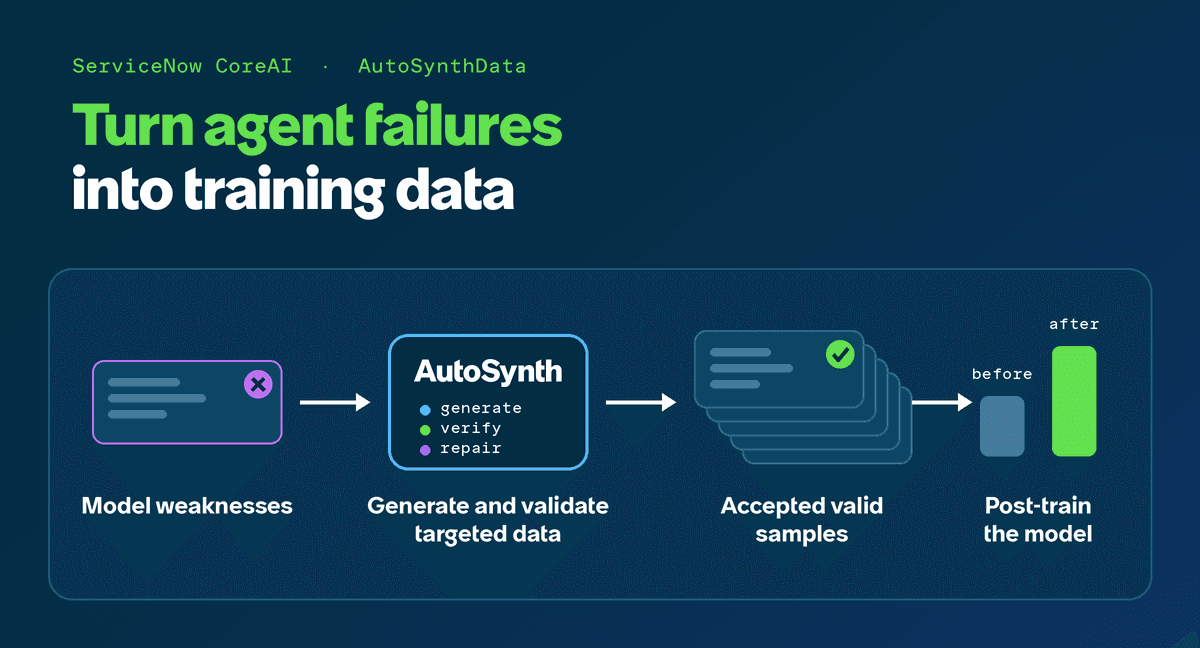
AutoSynthData:以企業 Agent 的失敗為師,自動生成高規格微調訓練資料
AutoSynthData: Generating Targeted Training Data from Enterprise Agent Failures
AutoSynthData 是 ServiceNow 開發的框架,透過分析企業 Agent 的失敗案例與強大導師模型的成功軌跡,自動生成具備可行性、真實性與挑戰性的微調資料,顯著提升 Agent 在特定企業環境中的任務達成率。
VISTA:為多模態 AI 打造的「長視域」互動式視覺輔助框架
VISTA: Empowering Multimodal Agents with a Long-Horizon Visual Harness
VISTA 是一個為多模態模型設計的視覺輔助框架,透過無損視覺記憶與主動檢索機制,顯著提升 AI 在複雜互動環境中的長視域推理與決策能力。
Google 發表新一代前沿模型 Gemini 4 Argon:具備 100 萬 Token 輸出與強大自主 Agent 推理能力
Google Announces Gemini 4 Argon: Frontier Model with 1M Output Tokens and Long-Horizon Reasoning
Google 發表新一代前沿模型 Gemini 4 Argon,將輸出 token 限制大幅擴充至 100 萬,專為解決軟體工程、資安防禦與企業工作流等複雜、長路徑任務而設計。