VISTA:為多模態 AI 打造的「長視域」互動式視覺輔助框架
VISTA: Empowering Multimodal Agents with a Long-Horizon Visual Harness
由何愷明(Kaiming He)等多位學者發表的 VISTA,是一套為多模態 AI 設計的通用視覺輔助框架。傳統模型難以在長時段的互動任務中維持穩定的視覺記憶,而 VISTA 讓模型能直接透過視覺觀察環境,並在「無損視覺記憶」中保存所有歷史畫面。在推理過程中,模型能主動檢索這些記錄並重新組織輸入。在 ARC-AGI-3 測試中,VISTA 將 Claude Opus 5.0 的表現提升至滿分 100,且使用的行動次數比人類初試者減少了 57.4%。
核心重點
長視域與無損視覺記憶
VISTA 完整保留過去的所有視覺觀測畫面,避免資訊在轉換或壓縮過程中流失。
主動檢索與輸入重組
模型在推理決策時,能主動檢索歷史視覺記錄並重新排列其視覺輸入。
突破性的動作效率表現
在 ARC-AGI-3 測試中,搭載 VISTA 的模型僅用人類 42.6% 的行動次數便完成所有任務。
極簡設計與跨環境通用性
VISTA 設計簡單,無需複雜調整即可無縫擴展至多個不同的視覺遊戲與謎題基準測試。
技術圖解
為什麼重要
傳統多模態模型在長期互動任務中常因缺乏系統性的視覺記憶而陷入瓶頸。VISTA 證明了「簡單的外部視覺輔助機制」能極大釋放現有模型(如 Claude Opus 5.0)的推理潛能,無需微調模型本體即可在 AGI 相關的視覺推理任務中超越人類效率。這為未來通用視覺智慧體(Visual Agents)在真實與虛擬互動環境中的部署奠定了重要基礎。
對誰有影響
- AI 開發者
- AI 研究人員
- 產品經理
可以怎麼使用
- 1互動式視覺遊戲與謎題求解器
- 2需要長期視覺狀態追蹤的自主多模態代理人
- 3複雜視覺 GUI 或網頁環境的操作與自動化導航
限制與注意事項
- 隨時間增長的視覺歷史可能會導致模型上下文視窗(Context Window)的 token 負擔加重。
- 當前主要在視覺遊戲與學術基準測試上進行評估,其在極度動態或即時的 3D 真實物理環境中的表現仍待驗證。
延伸閱讀
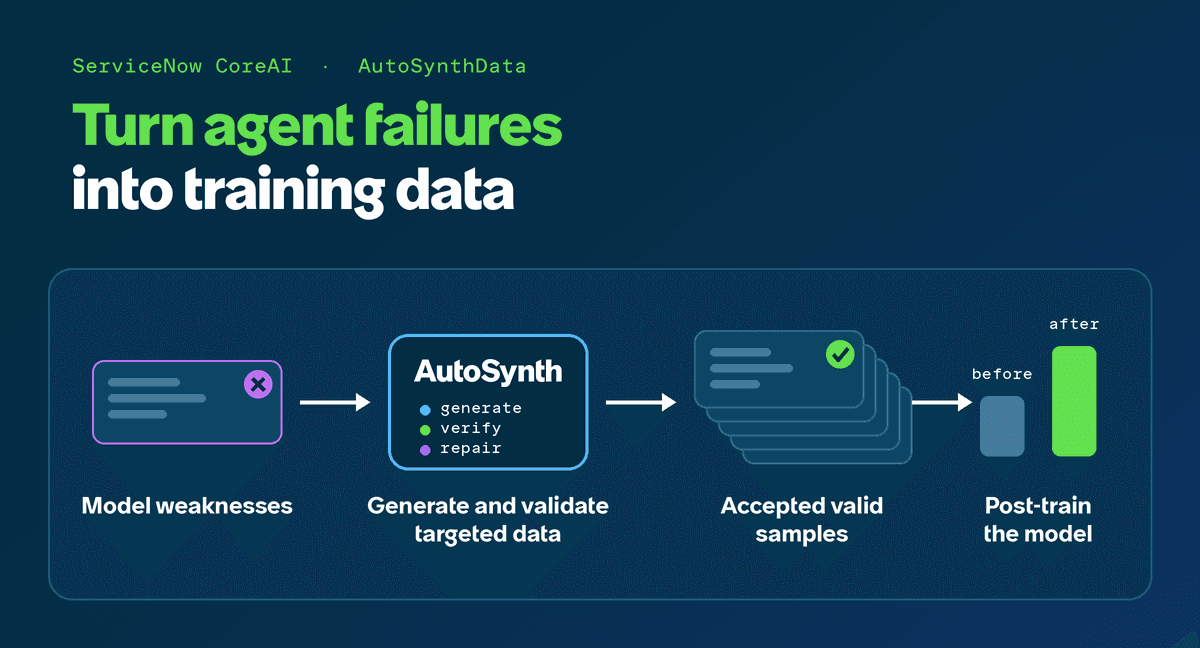
AutoSynthData:以企業 Agent 的失敗為師,自動生成高規格微調訓練資料
AutoSynthData: Generating Targeted Training Data from Enterprise Agent Failures
AutoSynthData 是 ServiceNow 開發的框架,透過分析企業 Agent 的失敗案例與強大導師模型的成功軌跡,自動生成具備可行性、真實性與挑戰性的微調資料,顯著提升 Agent 在特定企業環境中的任務達成率。
KaliBench:首個 Kali Linux 資安工具指令生成基準測試,助 8B 模型直逼 685B 巨獸
KaliBench: Evaluating and Boosting LLM Command Generation on Kali Linux
KaliBench 是一個專為 Kali Linux 設計的細粒度指令生成基準測試。研究發現,現有開源模型在無提示下的 CLI 指令準確度皆低於 42%,但透過其獨創的「免執行期可驗證獎勵」進行強化學習,能讓 8B 微型模型達到媲美 685B MoE 模型的表現。
Google 發表新一代前沿模型 Gemini 4 Argon:具備 100 萬 Token 輸出與強大自主 Agent 推理能力
Google Announces Gemini 4 Argon: Frontier Model with 1M Output Tokens and Long-Horizon Reasoning
Google 發表新一代前沿模型 Gemini 4 Argon,將輸出 token 限制大幅擴充至 100 萬,專為解決軟體工程、資安防禦與企業工作流等複雜、長路徑任務而設計。