Liquid AI 推出 open d1 邊緣決策模型:無需生成 Token、單次前向傳播即刻做出多模態決策
Liquid AI Unveils open d1: Ultra-Fast Edge Decision Models with Single-Pass Multimodal Inference
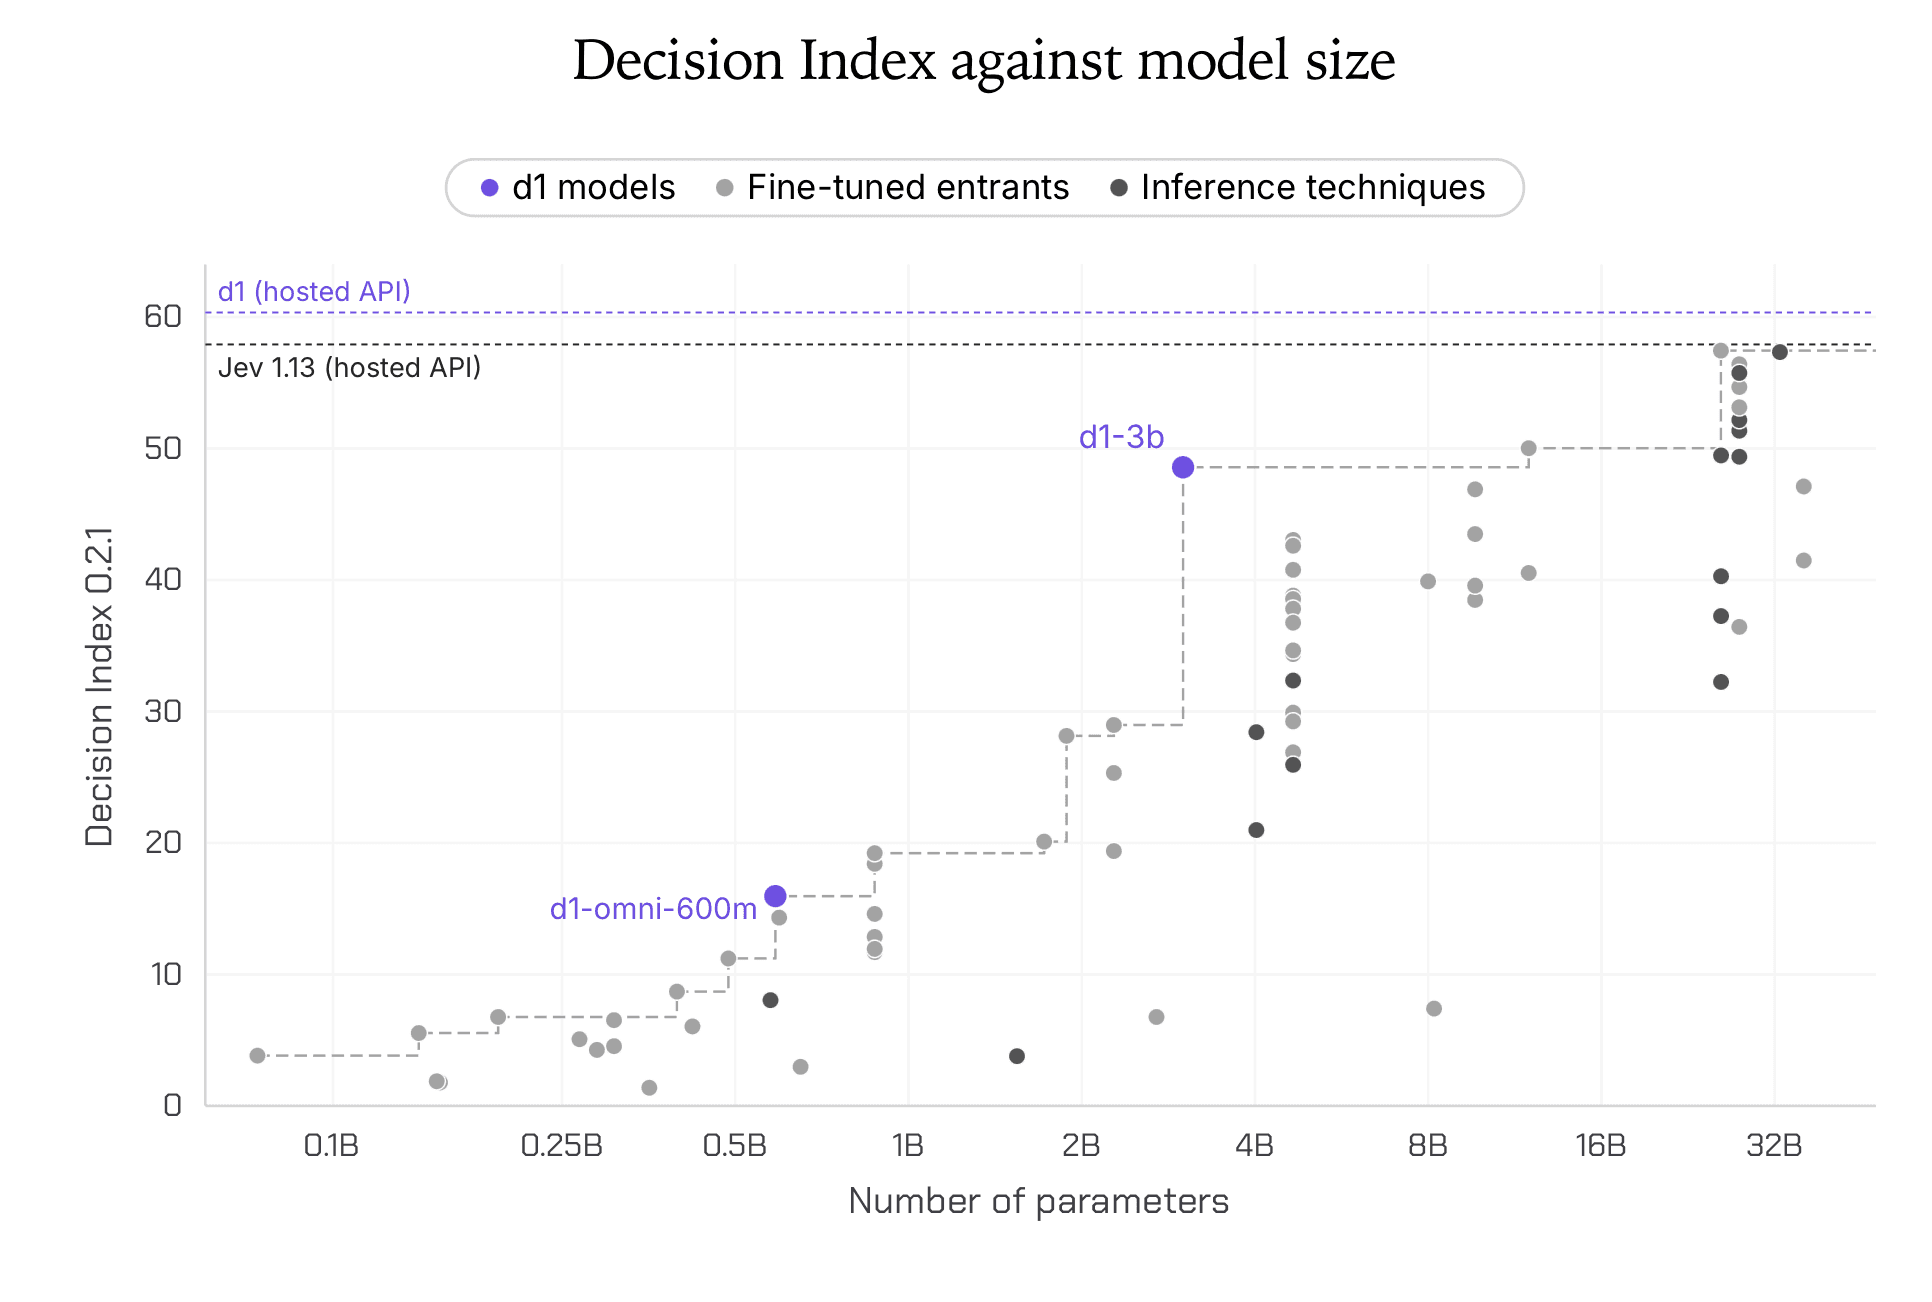
Liquid AI 發表了基於其液態基礎模型(LFM)的 open d1 系列決策模型。與傳統生成式模型不同,d1 模型不逐字生成 Token,而是透過單次前向傳播直接給出結構化答案,大幅縮短延遲。d1-3B 支援圖文輸入,在邊緣裝置(如 NVIDIA Jetson)上回答僅需不到 50 毫秒;d1-omni-600M 則為早期研究版,支援圖文或語音輸入,以僅四分之一的參數超越了 Decider 2B。
核心重點
無 Token 生成的單次傳播
不同於生成式模型,d1 透過單次前向傳播直接輸出結構化決策,免除逐字生成的高昂延遲。
優異的邊緣硬體效能
d1-3B 在 NVIDIA Jetson 晶片與 Apple M5 Pro 上的單一問題回答時間低於 50 毫秒,GPU 執行更低於 10 毫秒。
靈活的多模態決策能力
d1-3B 支援文字與影像輸入;而僅 600M 參數的 d1-omni 更能靈活處理文字與影像,或文字與語音的搭配。
技術圖解
| d1-3B | d1-omni-600M | |
|---|---|---|
| 參數大小 | 3B (30億) | 600M (6億) |
| 基礎架構 | LFM2.5-VL-3B (僅解碼器) | LFM2.5-Encoder-350M (雙向編碼器) |
| 支援模態 | 文字 + 影像 | 文字 + 影像 或是 文字 + 語音 |
| 平均基準測試分數 | 82.9 | 78.4 |
| 狀態 | 正式發布 / 已測試邊緣速度 | 早期研究版本 (Early Research) |
為什麼重要
這項技術展示了非生成式「決策模型」在邊緣裝置上的巨大潛力。透過跳過昂貴的 Token 生成步驟並直接在單次前向傳播中解決複雜任務,d1 讓即時、低延遲、隱私安全的本地多模態 AI 應用(如機器人控制、智慧物聯網、即時審查)變得切實可行,不再完全依賴昂貴的雲端 GPU。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
- 產品經理
可以怎麼使用
- 1智慧路由與意圖分類:自動將客訴或使用者指令快速分流至帳務、技術等部門。
- 2邊緣多模態內容審查:在本地設備上即時偵測影像與文字中的違規與不當內容。
- 3物聯網與機器人本地控制:依據感測器輸入的即時影音,在毫秒級的時間內做出控制決策。
限制與注意事項
- d1-omni-600M 目前仍處於早期研究發表階段,尚未公佈推論速度數據。
- 決策模型不具備文字生成能力,無法用於撰寫自由回覆或進行一般對話。
- 目前缺乏公開的語音決策基準測試,難以標準化評估音訊決策效能。
延伸閱讀
NVIDIA cuPhoton 開源工具套件:加速天文與科學影像端到端 GPU 分析
NVIDIA cuPhoton: Accelerating End-to-End Scientific Image Analysis on GPUs
NVIDIA 推出開源 CUDA-X 工具套件 cuPhoton,提供從資料載入、影像對齊、影像相減到雙極擬合的完整 GPU 原生管線,解決天文與科學研究中龐大的運算瓶頸。
NVIDIA 推出 DIN Deploy:用 C++ 與 TensorRT RTX 打造高效能地端 AI 應用程式
NVIDIA DIN Deploy: Building High-Performance Local AI Apps with C++ and TensorRT RTX
NVIDIA 開源 DIN Deploy 專案,結合 ONNX Runtime 與 TensorRT RTX,提供 C++ 範例以協助開發人員將語音識別、影像分割及圖像生成模型快速部署至 Windows 與 Linux 地端系統。
打造 AI 原生專案:NVIDIA TensorRT Model Connect 的開發啟示
Designing AI-Native Software: Lessons from NVIDIA TensorRT Model Connect
NVIDIA 分享如何圍繞 AI 代理(Coding Agent)重新設計軟體架構,透過模型家族隔離、可逆變更與 GPU 自動驗證,成功擴充 TensorRT Model Connect 開源專案。