NVIDIA cuPhoton 開源工具套件:加速天文與科學影像端到端 GPU 分析
NVIDIA cuPhoton: Accelerating End-to-End Scientific Image Analysis on GPUs
科學儀器(如魯賓天文台的 LSSTCam)產生資料的速度遠超傳統 CPU 的處理極限。NVIDIA cuPhoton 藉由將資料從感測器讀取到最終決策全程保留在 GPU 上,徹底消除了 PCIe 傳輸與主機端解壓縮的瓶頸。在實際測試中,cuPhoton 實現了高達 14,900 倍的資料載入加速與 14,550 倍的訊號處理加速,成功將長達九個月的分析工作縮短至僅四小時完成。
核心重點
GPU 原生端到端路徑
影像資料從原始感測器讀取、對齊、相減、擬合到分類全程保留在 GPU 上,完全消除主機與裝置間的資料移動開銷。
極致的硬體加速
在大規模工作負載下,資料載入加速達 14,900 倍,訊號處理加速達 14,550 倍,將數月的分析時間轉化為幾分鐘或小時。
專屬科學模組陣容
整合 xDataReader、xRep、xPois、xFit 與 xScan 等模組,分別處理 FITS 影像載入、重投影、PSF 匹配和候選天體篩選審查。
支援大規模分散式擴充
支援跨多 GPU、多節點的 Grace Blackwell 和 Vera Rubin 系統,無縫應對天文台等級的巨大數據流。
技術圖解
為什麼重要
現代天文台每隔數十秒就會產生數億像素的影像,舊有的 CPU 工作管線常需要數月甚至一年才能得出分析結果。cuPhoton 成功將這個延遲縮短至秒級,讓科學家能即時對超新星、小行星等「天文暫現源」進行互動式分析與即時預警,徹底釋放新一代大口徑觀測設施的發現潛能。
對誰有影響
- AI 研究人員
- AI 開發者
- 企業決策者
可以怎麼使用
- 1天文影像重投影與高精度時域變動源篩選
- 2大口徑望遠鏡(如魯賓天文台)即時觀測數據流分析
- 3時域雷射與高通量 X 光探測器的極速訊號解析
限制與注意事項
- 目前僅支援 Linux 系統、特定 Python (3.12–3.14) 與 CUDA 13 環境。
- xDataReader 模組尚不支援 Rice 壓縮算法及抖動浮點量化(dithered floating-point quantization)。
延伸閱讀
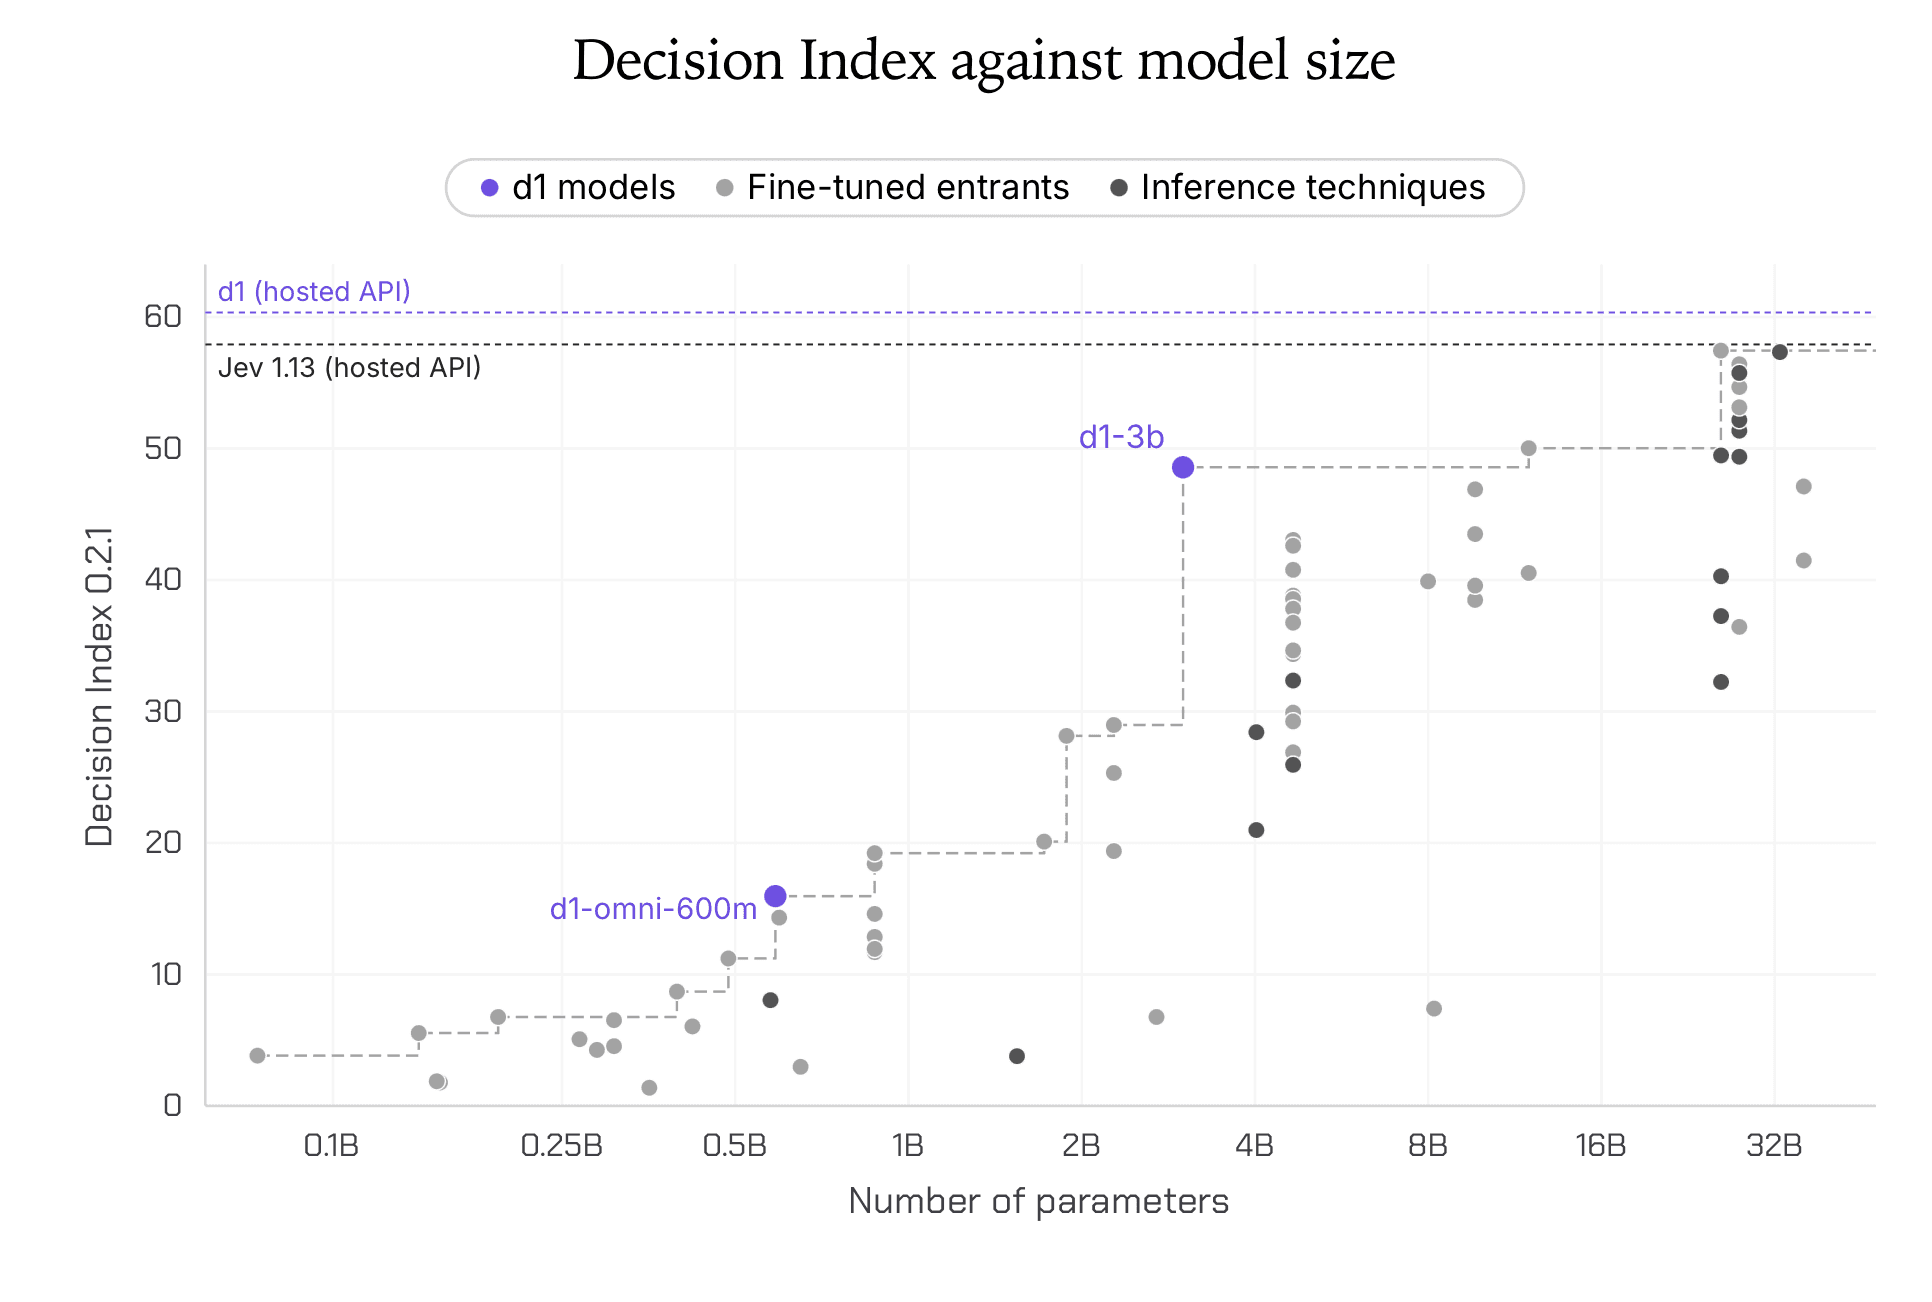
Liquid AI 推出 open d1 邊緣決策模型:無需生成 Token、單次前向傳播即刻做出多模態決策
Liquid AI Unveils open d1: Ultra-Fast Edge Decision Models with Single-Pass Multimodal Inference
Liquid AI 推出專為邊緣裝置設計的 open d1 決策模型,包含 d1-3B 與 d1-omni-600M,不生成 Token 而是透過單次前向傳播直接輸出多模態決策。
NVIDIA 推出 DIN Deploy:用 C++ 與 TensorRT RTX 打造高效能地端 AI 應用程式
NVIDIA DIN Deploy: Building High-Performance Local AI Apps with C++ and TensorRT RTX
NVIDIA 開源 DIN Deploy 專案,結合 ONNX Runtime 與 TensorRT RTX,提供 C++ 範例以協助開發人員將語音識別、影像分割及圖像生成模型快速部署至 Windows 與 Linux 地端系統。
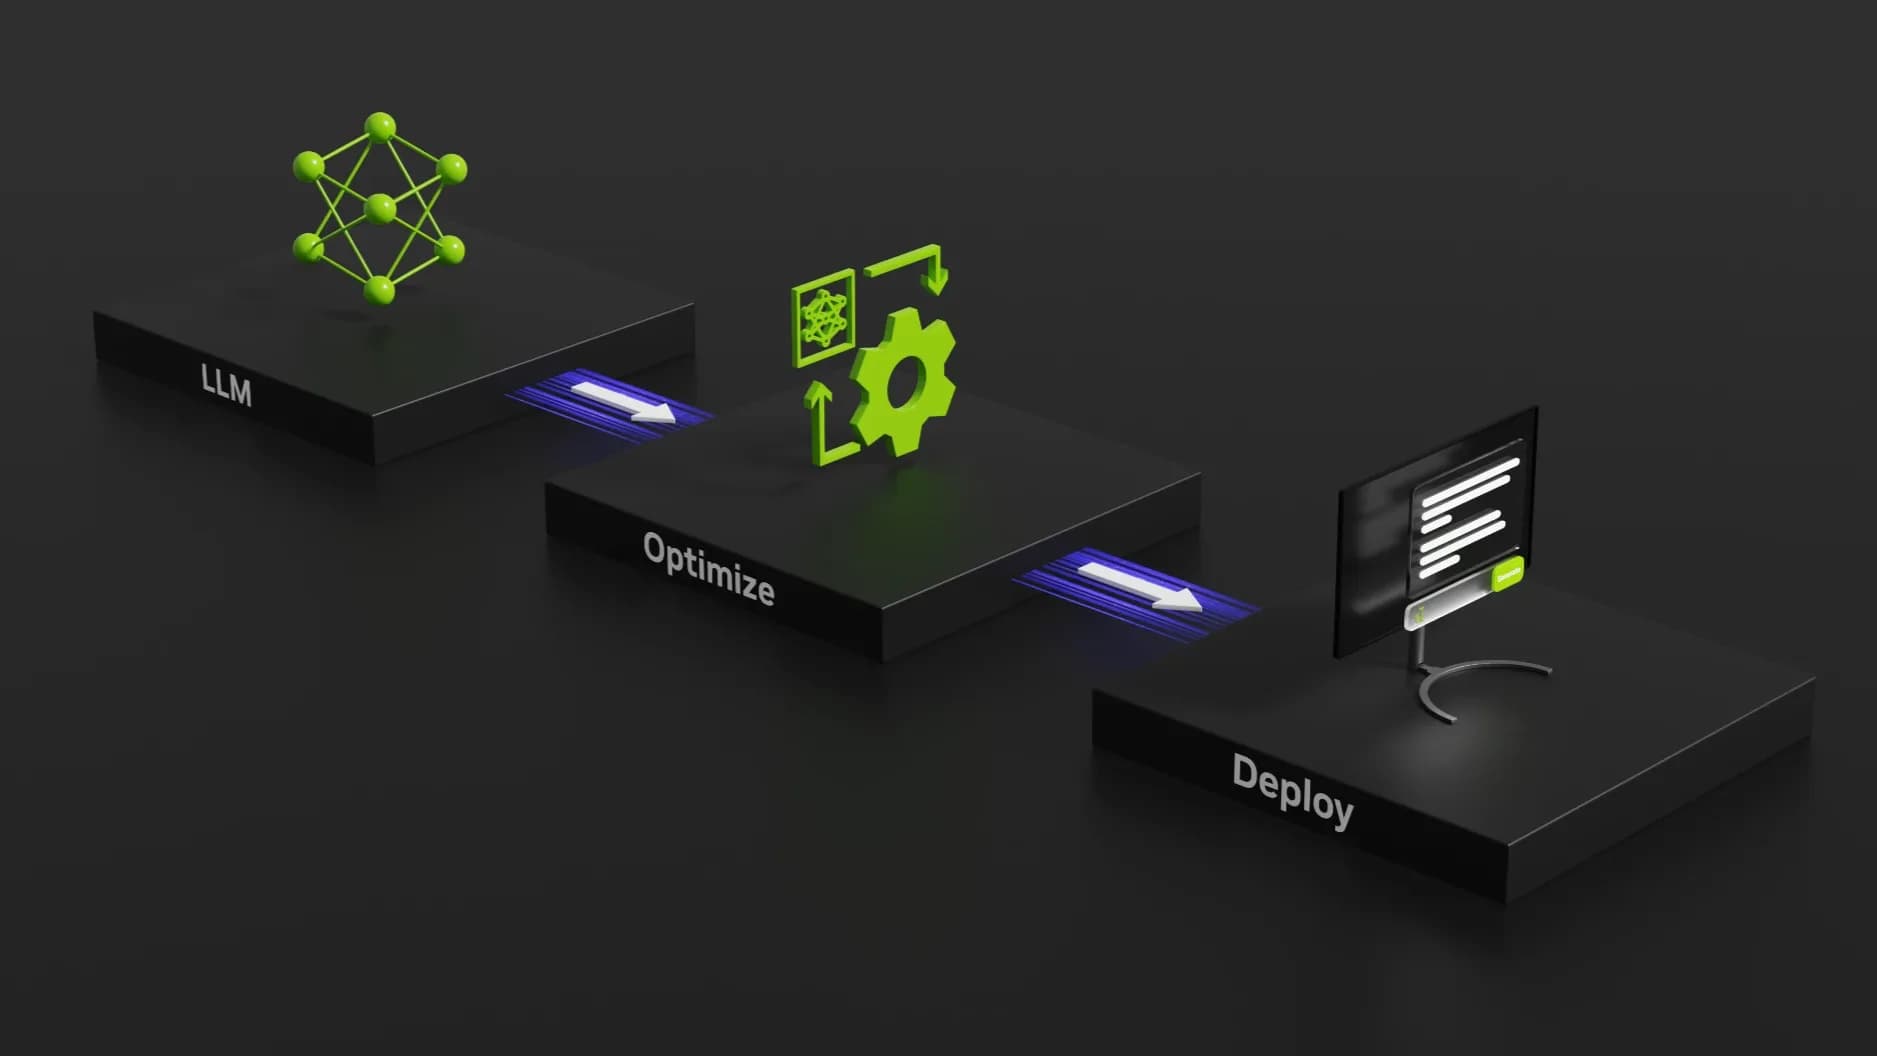
打造 AI 原生專案:NVIDIA TensorRT Model Connect 的開發啟示
Designing AI-Native Software: Lessons from NVIDIA TensorRT Model Connect
NVIDIA 分享如何圍繞 AI 代理(Coding Agent)重新設計軟體架構,透過模型家族隔離、可逆變更與 GPU 自動驗證,成功擴充 TensorRT Model Connect 開源專案。