拒絕張冠李戴:ProvenanceGuard 為 MCP 代理帶來「來源感知」事實查核
Stopping Cross-Source Conflation: ProvenanceGuard Brings Source-Aware Verification to MCP Agents
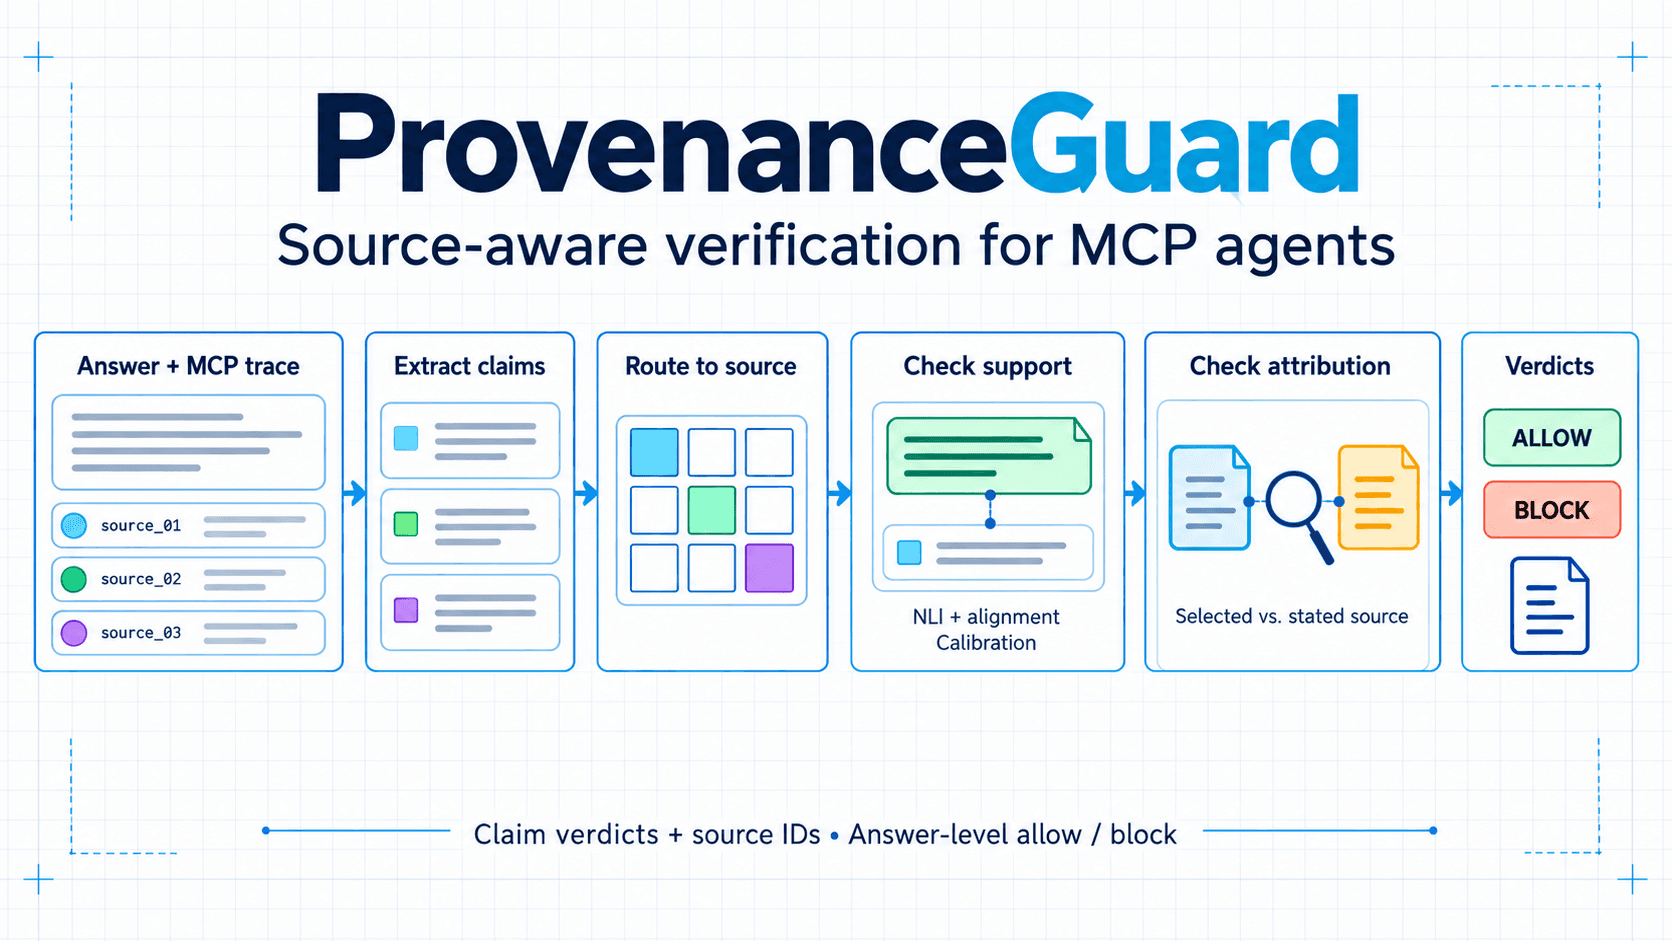
當 LLM 代理從多個管道(如病歷、研究文獻)獲取資訊時,常會發生「將 A 管道的真實資訊誤植為 B 管道提供」的狀況。傳統查核工具僅看事實是否存在,無法偵測這種「來源錯置」。ProvenanceGuard 透過五步驟管線,在不需重新訓練模型的情況下,追蹤 MCP 工具輸出的來源 ID,逐句拆解回答、定位來源、驗證支持度並比對歸屬。在醫療資料測試中,成功阻截了 139 個錯誤中的 138 個,阻截 F1 值達 0.802,超越現有 RAG 評估工具。
核心重點
防止跨來源混淆
傳統驗證工具僅「盲檢」事實是否存在,容易忽略將 A 來源事實歸咎給 B 來源的錯誤。
無需重新訓練的外掛層
作為黑盒代理之上的後處理層,直接讀取 MCP 追蹤軌跡與來源 ID,不影響原有模型權重。
五步驟驗證與修復
依序進行拆解主張、精準路由、支持度評估、來源歸屬檢查、輸出決策,並支援 RARR 式的自動修復。
領先同類的阻截表現
在醫療領域測試中,成功攔截近 100% 的錯誤,阻截 F1 分數(0.802)高於 MiniCheck、RAGAS 等主流工具。
技術圖解
為什麼重要
在醫療、金融與法律等高敏感領域,「事實正確但引述錯誤」的損害與「假新聞」一樣嚴重。ProvenanceGuard 提供了一種可解釋的機制,不僅給出通過與否的判斷,還能精確指出每一條主張對應的工具來源 ID。此技術已被導入 NVIDIA NVFlow 的金融代理中,顯示出極高實用價值。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
- 產品經理
可以怎麼使用
- 1醫療診斷助理:區分患者病歷與一般醫學文獻的資訊來源,防止混淆。
- 2金融合規審查:在回答 SEC 報告等法規諮詢時,精確比對並標註資料來源。
限制與注意事項
- 辨識高度相似來源(如多個相似文件)的精準度仍有待提升(在極端相似測試中正確率僅 50.3%)。
- 當前主要使用本地端小模型(MiniLM, DeBERTa)進行評估,若遷移至雲端託管模型需額外進行校準與測試。
延伸閱讀
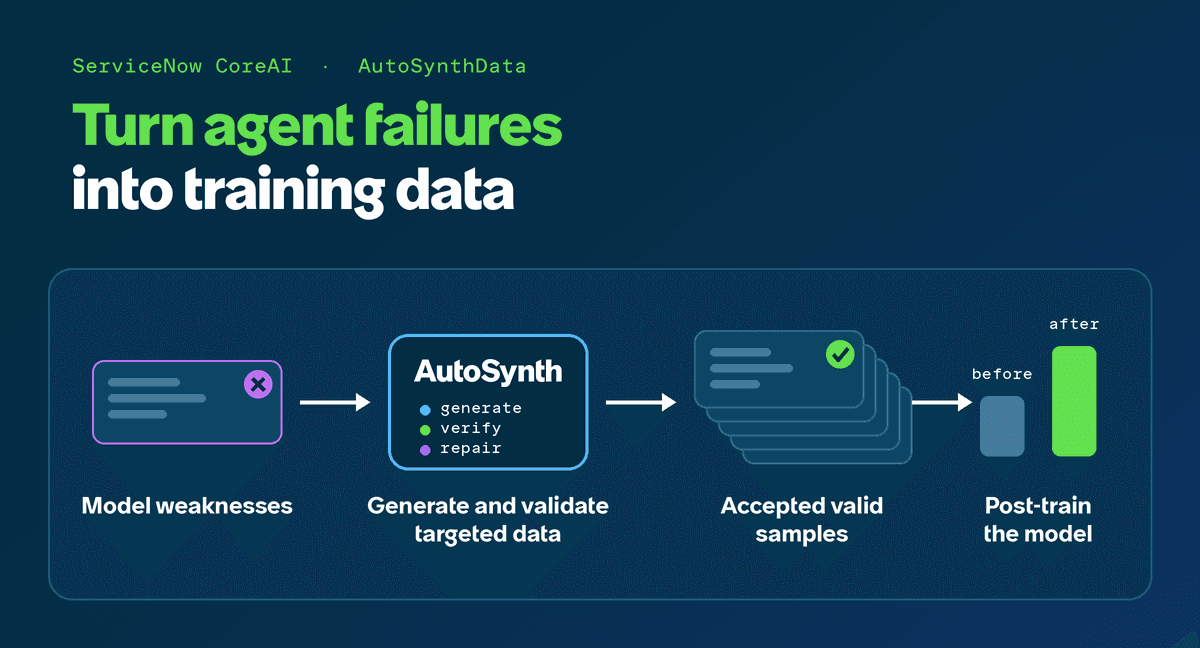
AutoSynthData:以企業 Agent 的失敗為師,自動生成高規格微調訓練資料
AutoSynthData: Generating Targeted Training Data from Enterprise Agent Failures
AutoSynthData 是 ServiceNow 開發的框架,透過分析企業 Agent 的失敗案例與強大導師模型的成功軌跡,自動生成具備可行性、真實性與挑戰性的微調資料,顯著提升 Agent 在特定企業環境中的任務達成率。
KaliBench:首個 Kali Linux 資安工具指令生成基準測試,助 8B 模型直逼 685B 巨獸
KaliBench: Evaluating and Boosting LLM Command Generation on Kali Linux
KaliBench 是一個專為 Kali Linux 設計的細粒度指令生成基準測試。研究發現,現有開源模型在無提示下的 CLI 指令準確度皆低於 42%,但透過其獨創的「免執行期可驗證獎勵」進行強化學習,能讓 8B 微型模型達到媲美 685B MoE 模型的表現。
VISTA:為多模態 AI 打造的「長視域」互動式視覺輔助框架
VISTA: Empowering Multimodal Agents with a Long-Horizon Visual Harness
VISTA 是一個為多模態模型設計的視覺輔助框架,透過無損視覺記憶與主動檢索機制,顯著提升 AI 在複雜互動環境中的長視域推理與決策能力。