從工具調用到任務完成:如何系統化評估 AI Agent
From Tool Calls to Task Completion: How to Systematically Evaluate AI Agents
傳統的評估方法(如 BFCL)僅能測試單次的工具呼叫,但真實的 AI Agent 必須在動態環境中執行多步驟任務、處理錯誤並維持狀態。現代的 Agent 評估核心在於「執行環境」,透過結合「端到端(E2E)結果評估」(驗證目標狀態是否達成)與「步驟級(過程)評估」(追蹤工具調用軌跡與參數正確性),來優化 Agent 的穩定性、成本與執行效率。
核心重點
評估核心轉向執行環境
單次工具呼叫正確不代表任務能順利完成。評估必須在具備狀態變更的真實或模擬環境中,驗證任務結束後的最終狀態是否符合預期。
雙層評估架構
端到端(E2E)評估關注最終結果(如退款是否成功),是發佈生產環境的標準;步驟級(過程)評估則追蹤每一步的合理性,用於開發與微調除錯。
建立三大維度的核心指標
除了追蹤成功率與一致性(3-5 次試驗)等「準確性」指標,還需衡量「冗長度」(每次成功所需步驟)與「成本」(每次成功所需花費)。
高品質評估的三大維度
優良的基準測試具備高複雜度與狀態維持能力,並以「可執行驗證」(如單元測試或資料庫變更)為黃金標準,而非僅依賴 LLM 作為裁判。
技術圖解
| 步驟級(過程)評估 / Process Scoring | 端到端(結果)評估 / Outcome Scoring | |
|---|---|---|
| 評估焦點 | 評估單次工具呼叫是否有效、相關、且對當前狀態有用 | 忽略路徑,僅確認最終的系統或環境狀態是否達成目標 |
| 主要用途 | 開發、除錯與模型微調(找出是哪一步驟導致工具調用鏈斷裂) | 生產環境發佈的檢驗閘口(衡量用戶經歷的真實成效) |
| 對冗餘步驟的反應 | 會扣減「工具調用精準度」與步驟分數(例如做了無效的檔案檢視) | 不影響分數,只要最終結果正確,即判定為成功(成功率為 1) |
| 評估對象 | 追蹤紀錄(Trace)中的每一行對話與個別工具參數 | 任務結束後的資料庫狀態、通過的程式測試或關閉的工單 |
為什麼重要
隨著企業將 AI Agent 部署至真實業務場景,單純測試模型「回答聽起來是否正確」已無法滿足需求。無法與環境互動、無法從錯誤步驟中恢復的 Agent 會直接導致業務失敗。透過系統化的 Agent 評估架構(追蹤成功率、一致性、步驟成本),企業能精確量化 Agent 的穩定性,並在部署前精準定位哪一個步驟的工具呼叫導致了鏈條斷裂,是實現企業級 AI 應用的關鍵基礎。
對誰有影響
- AI 開發者
- AI 研究人員
- 產品經理
- 企業決策者
可以怎麼使用
- 1使用 SWE-bench Verified 評估 AI 編碼 Agent 瀏覽程式庫、編寫修補程式並通過真實單元測試的能力。
- 2基於企業私有領域的 API、資料庫與真實服務工單,建立自有的 Agent 評估集以進行發佈前閘口測試。
- 3追蹤 Agent 多輪對話中的工具調用軌跡,找出並消除冗餘步驟(如不必要的檔案讀取),以降低權杖成本與延遲。
限制與注意事項
- 評估容易遭受「資料污染」,例如網頁搜尋型 Agent 在測試中直接檢索到答案,或公開測試集被重新抓取並納入預訓練語料庫中。
- 在缺乏「可執行驗證」的場景中,LLM 裁判(LLM-as-a-Judge)雖可填補空白,但其評分具有不確定性,必須定期與人類專家評分進行交叉驗證。
延伸閱讀
為什麼 Agent 的對話會騙人?微軟與 HF 推出 ThinkingBox 評測真實資料庫狀態
The Agent Said It Was Done, the Database Disagreed: Introducing ThinkingBox
傳統評測只看對話和工具呼叫,微軟與 Hugging Face 推出的 ThinkingBox 則改用「資料庫最終狀態」與「副作用」來檢驗 Agent 的真實可靠度。
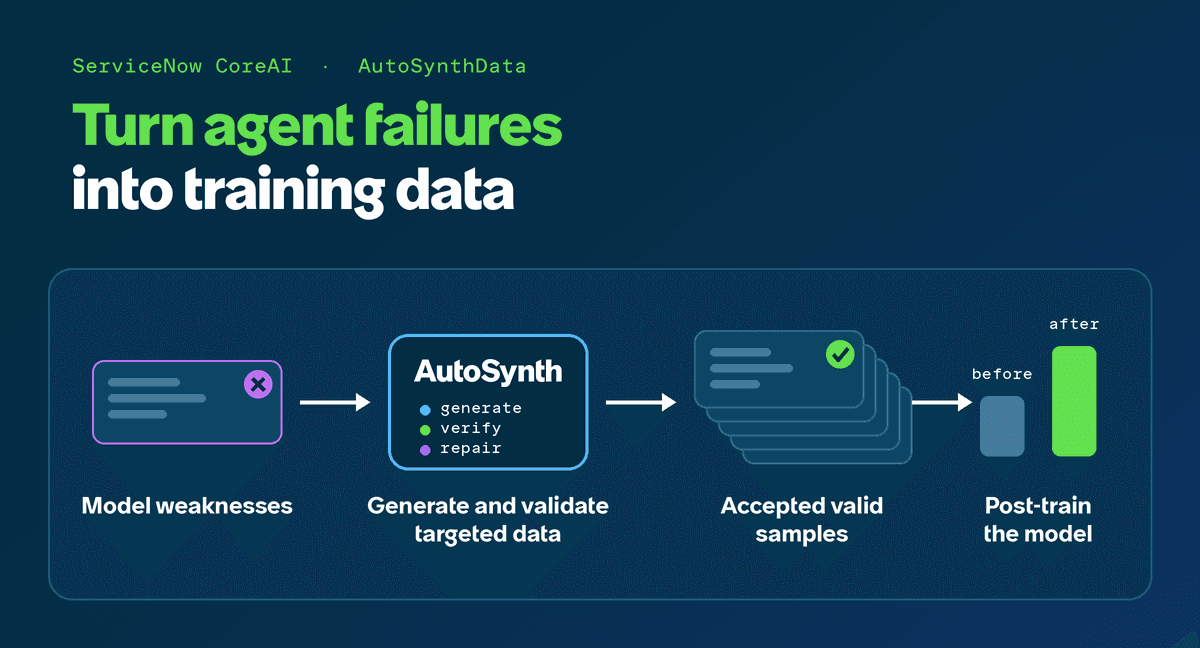
AutoSynthData:以企業 Agent 的失敗為師,自動生成高規格微調訓練資料
AutoSynthData: Generating Targeted Training Data from Enterprise Agent Failures
AutoSynthData 是 ServiceNow 開發的框架,透過分析企業 Agent 的失敗案例與強大導師模型的成功軌跡,自動生成具備可行性、真實性與挑戰性的微調資料,顯著提升 Agent 在特定企業環境中的任務達成率。
KaliBench:首個 Kali Linux 資安工具指令生成基準測試,助 8B 模型直逼 685B 巨獸
KaliBench: Evaluating and Boosting LLM Command Generation on Kali Linux
KaliBench 是一個專為 Kali Linux 設計的細粒度指令生成基準測試。研究發現,現有開源模型在無提示下的 CLI 指令準確度皆低於 42%,但透過其獨創的「免執行期可驗證獎勵」進行強化學習,能讓 8B 微型模型達到媲美 685B MoE 模型的表現。