為什麼 Agent 的對話會騙人?微軟與 HF 推出 ThinkingBox 評測真實資料庫狀態
The Agent Said It Was Done, the Database Disagreed: Introducing ThinkingBox
ThinkingBox 是一個專為 Agent 設計的沙盒評測機制,包含 507 個狀態化業務流程。研究發現,在 67.24% 的失敗案例中,Agent 表面上都順利執行完畢且無錯誤訊息,但實際檢查資料庫時卻發現了錯誤欄位或多餘副作用。藉由重複執行各任務 20 次,ThinkingBox 揭示了部分模型(如 Kimi-K3)雖有極高的解題覆蓋率,但在「每一次都做對」的穩定度上,仍大幅落後於 Claude Opus 5.5 等模型。
核心重點
資料庫狀態才是唯一真理
評估 Agent 不能只看對話或工具呼叫軌跡,必須檢測資料庫最終寫入的值與系統產生的副作用。
表面成功不等於真正完成
在失敗的嘗試中,有高達 67.24% 的 Agent 表面上順利執行完畢且無報錯,但實際上有 77.61% 出現欄位錯誤。
重複測試揭露穩定度落差
透過重複執行 20 次,發現 Kimi-K3 能解開高達 93.89% 的任務,但完全一致正確的機率(20/20)僅有 13.41%。
衡量「可靠任務成本」
引進「可靠任務成本」,即成功完成全部 20 次測試的平均花費,其中 GPT-5.4 與 Claude Opus 5.5 位於效能前沿。
技術圖解
為什麼重要
企業部署 Agent 最怕「無聲的失敗」——Agent 告訴客戶問題已處理,但資料庫根本沒更新或更新錯誤。ThinkingBox 提供了一個實用的測試框架,並與 OpenEnv 整合,讓開發者能在將 Agent 投入生產環境前,先用真實的狀態比對來做單元測試,防範系統出錯並精準掌控 API Token 成本。
對誰有影響
- AI 開發者
- AI 研究人員
- 企業決策者
- 產品經理
可以怎麼使用
- 1評估企業級 Agent 在多次重複呼叫下的系統穩定度與錯誤恢復能力。
- 2整合至 CI/CD 流程中,自動對 Agent 寫入資料庫的「副作用」進行單元測試與檢驗。
限制與注意事項
- 評測任務均為基於真實企業場景設計的合成模擬,並非真實客戶資料。
- 評估 20 次重複測試的 API Token 成本高昂,對中小型團隊而言負擔較大。
延伸閱讀
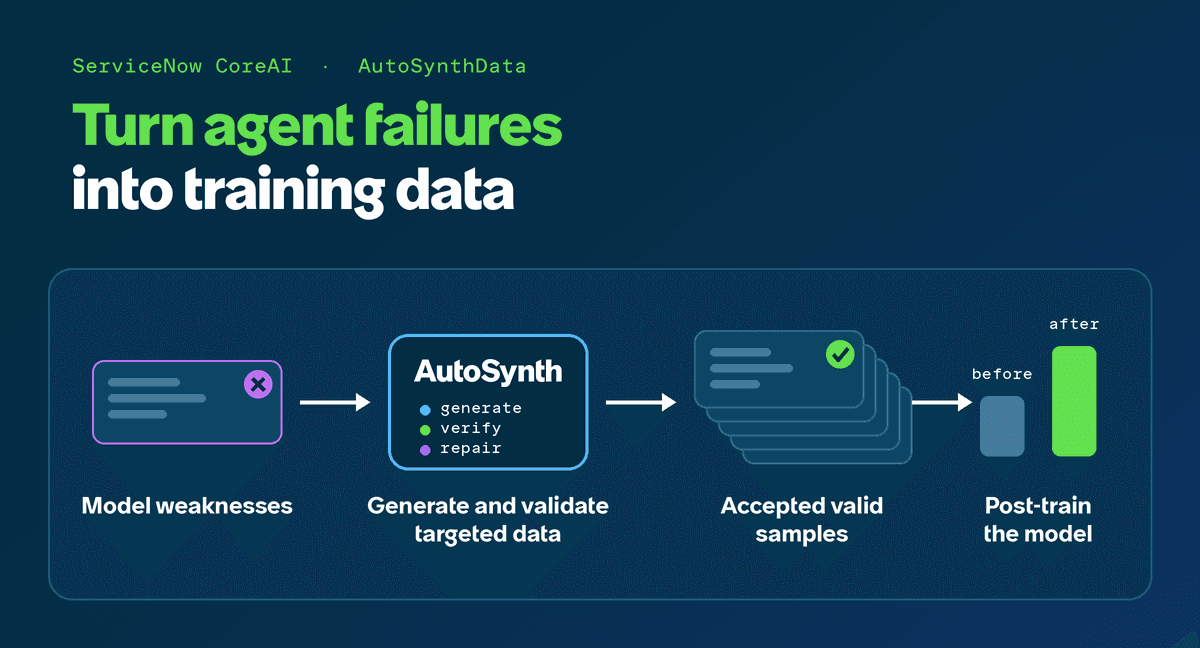
AutoSynthData:以企業 Agent 的失敗為師,自動生成高規格微調訓練資料
AutoSynthData: Generating Targeted Training Data from Enterprise Agent Failures
AutoSynthData 是 ServiceNow 開發的框架,透過分析企業 Agent 的失敗案例與強大導師模型的成功軌跡,自動生成具備可行性、真實性與挑戰性的微調資料,顯著提升 Agent 在特定企業環境中的任務達成率。
KaliBench:首個 Kali Linux 資安工具指令生成基準測試,助 8B 模型直逼 685B 巨獸
KaliBench: Evaluating and Boosting LLM Command Generation on Kali Linux
KaliBench 是一個專為 Kali Linux 設計的細粒度指令生成基準測試。研究發現,現有開源模型在無提示下的 CLI 指令準確度皆低於 42%,但透過其獨創的「免執行期可驗證獎勵」進行強化學習,能讓 8B 微型模型達到媲美 685B MoE 模型的表現。
VISTA:為多模態 AI 打造的「長視域」互動式視覺輔助框架
VISTA: Empowering Multimodal Agents with a Long-Horizon Visual Harness
VISTA 是一個為多模態模型設計的視覺輔助框架,透過無損視覺記憶與主動檢索機制,顯著提升 AI 在複雜互動環境中的長視域推理與決策能力。