AI Daily ·
AI 代理自我進化、終端指令生成與高效率微調新突破
Today’s AI Highlights
今日 AI 領域迎來多項關鍵進展:在代理與指令生成方面,RPG 框架透過模擬練習與失敗診斷,讓具身代理在不更新模型權重下將任務成功率提升至 95%;同時 KaliBench 評測與強化訓練讓 8B 模型在 Kali Linux 指令生成上媲美超大型 MoE 模型。此外,TACO 最佳化器實現了單張 GPU 進行 32B 模型全參數微調的突破,大幅降低硬體門檻。
- 01arXivAI 代理
KaliBench:首個 Kali Linux 資安工具指令生成基準測試,助 8B 模型直逼 685B 巨獸
在資安自動化中,LLM 需要將分析師意圖精確轉譯成不容出錯的終端機命令。KaliBench 填補了這一評測空白,包含 8,504 個自然語言對 CLI 命令的配對,涵蓋 1,642 個 Kali Linux 工具。測試結果顯示,開源大模型在無提示時的命令精確度普遍極低(均低於 42%)。為了優化此能力,KaliBench 設計了多階段驗證管道,並提供「免執行期可驗證獎勵」,讓 8B 小模型能以低成本進行強化學習,最終展現出比肩 685B MoE 旗艦模型的操作水準。
- 02arXiv機器人
自主學習免微調!「RPG」框架藉由虛擬練習與自我診斷,將機器人任務成功率提升至 95%
傳統機器人學習高度依賴人力設計獎勵與微調模型。UC Berkeley 等機構的研究團隊提出「RPG」(Reconstruct, Practice, Go Real)框架,直接從離線資料集重建模擬任務,並利用特權狀態與影片自我診斷失敗原因,自主生成並修正符號技能(Symbolic Skills)與系統提示詞。在 22 個操縱任務中,RPG 將成功率從 28.6% 提升至 95.0%(超越 GPT-6 驅動的基線),且在實體機器人測試中達到 100% 成功率。
- 03arXivAI 代理
VISTA:為多模態 AI 打造的「長視域」互動式視覺輔助框架
由何愷明(Kaiming He)等多位學者發表的 VISTA,是一套為多模態 AI 設計的通用視覺輔助框架。傳統模型難以在長時段的互動任務中維持穩定的視覺記憶,而 VISTA 讓模型能直接透過視覺觀察環境,並在「無損視覺記憶」中保存所有歷史畫面。在推理過程中,模型能主動檢索這些記錄並重新組織輸入。在 ARC-AGI-3 測試中,VISTA 將 Claude Opus 5.0 的表現提升至滿分 100,且使用的行動次數比人類初試者減少了 57.4%。
- 04arXiv大型語言模型
TACO 最佳化器:將 32B 大模型全參數微調帶入單張 GPU 的極簡幾何學
傳統 LLM 全參數微調受限於 AdamW 等最佳化器巨大的記憶體開銷。本研究提出 TACO 最佳化器,承襲 Muon 的最陡下降法視角,在二維權重矩陣的每一行中,僅選取絕對值最大的梯度元素並保留其正負號(三值化與極稀疏化)。在 OPT-13B 微調測試中,TACO 將最佳化器狀態記憶體從 AdamW8bit 的 27.7 GB 驟降至 0.16 GB(減少 174 倍),峰值訓練記憶體降低 2.9 倍,且維持與 AdamW 相當的精確度。這使開發者能在單張 80 GB H100 GPU 上,對 30-32B 規模的模型進行全參數微調。
- 05arXiv大型語言模型
層級連續擴散語言模型:結合離散 Token 與連續潛在軌跡的全新生成架構
傳統離散擴散模型在並行解碼時會因獨立採樣而破壞 Token 間的統計依賴;連續擴散模型則因缺乏與有效 Token 的連結而難以保證生成品質。為解決此瓶頸,研究團隊提出 HC-DLM(層級連續擴散語言模型)。HC-DLM 以連續潛在狀態作為唯一的持久生成狀態,並在每一步去噪中讀出離散 Token 作為下一步潛在更新的支撐。實驗顯示,HC-DLM 在數獨求解、倒數計時規劃與 LM1B 語言建模任務中,表現皆顯著優於傳統擴散模型基線。
- 06arXivAI 研究
LLM 數學推理的「失落基元」:如何診斷並修復模型缺乏的結構化理解?
儘管大型語言模型(LLM)在數學題目的表現上看似亮眼,但它們是否真正理解背後的結構化數學原理仍存疑問。本研究引入了「數學基元(Mathematical Primitive)」的概念,並提出一個全新的評估基準,從「發現、生成、消化、執行」四個維度系統性診斷 LLM 的數學能力。研究指出,解題準確率常掩蓋了模型內部能力的缺陷,而「發現(Discovery)」能力是限制推理表現的最大瓶頸。為了解決此問題,團隊開發了一個基元引導的自蒸餾框架,成功將這種推理結構轉移給學生模型,在各大基準測試中均取得顯著進步。
- 07arXivAI 研究
突破無結構蛋白設計瓶頸!IDiom 與 RL-SAE 開創可解釋性的蛋白質功能定製
無結構蛋白區域(IDR)由於缺乏固定三維結構,難以使用傳統基於結構的蛋白質設計方法。對此,研究團隊訓練了在 5400 萬個預測 IDR 序列(IDiom-DB)上的自迴歸模型 IDiom。為了精準引導序列生成,團隊推出 RL-SAE(基於稀疏自編碼器特徵的強化學習)微調技術。在 8 項設計任務中,RL-SAE 能成功啟用平均 90% 的目標特徵(對照引導技術僅有 24%),大幅提升了次細胞定位與轉錄活性預測的表現。
- 08arXivAI 研究
DMAD:將分佈匹配重塑為對抗蒸餾,實現超快速視覺生成
傳統分佈匹配蒸餾(DMD)為了訓練少步數的學生模型,必須維持一個輔助擴散模型來估算學生模型動態變化的分佈,造成極大的運算負擔。DMAD 創新地將分佈匹配問題轉化為分類任務,在共享的主幹網路上部署雙判別器標頭,直接學習對數密度比。透過這種對抗蒸餾設計,DMAD 在不需輔助模型的情況下成功還原分佈匹配梯度,並在 ImageNet、SDXL、Wan2.1 及 MiniMax 等多種影像與影片生成任務中,展現出超越基準模型的極致效能與生成速度。
 09Hugging Face大型語言模型
Olmo-core 3 登場:開源兆級參數 MoE 模型訓練基礎架構
Olmo-core 3 重新設計了 MoE 訓練系統,將原有的 FSDP 架構轉為基於 DDP 的設計,讓專家網路常駐 GPU 以減少權重傳輸。在 NVIDIA B300 GPU 測試中,47B MoE 模型的訓練吞吐量比舊版提升了 2.7 倍。此系統不僅能擴展至兆級參數,更支援 MXFP8 低精度格式、專家平行與分散式優化器等多種技術,為開源社群提供高效的巨型模型訓練工具。
 10Hugging FaceAI 代理
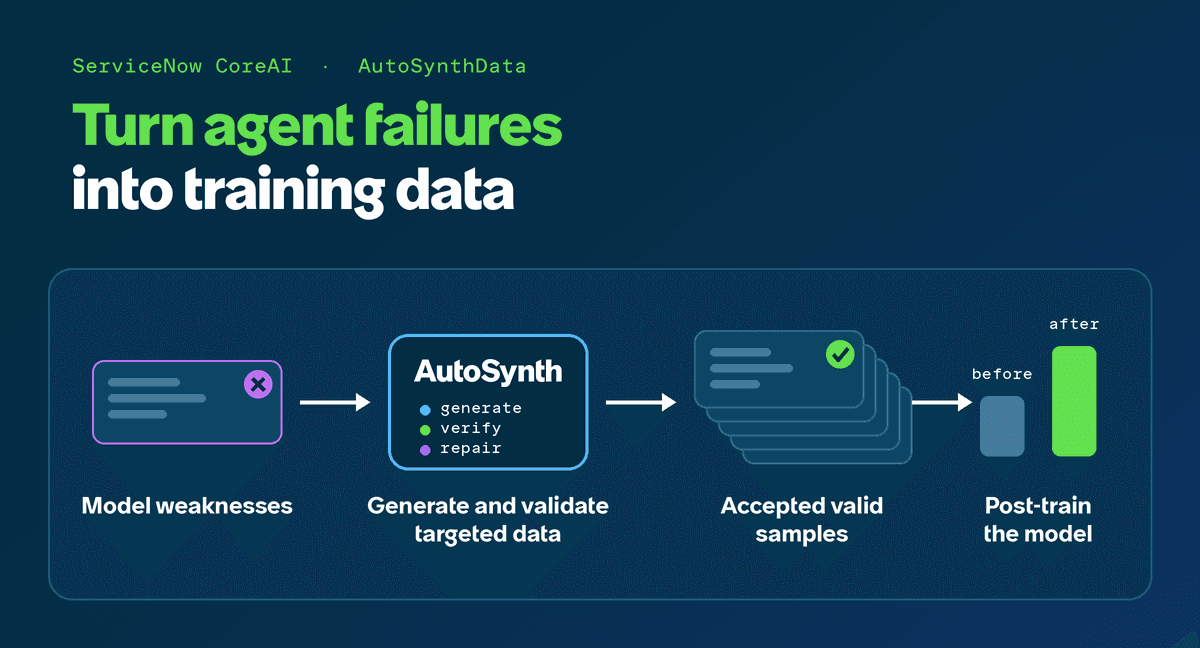
AutoSynthData:以企業 Agent 的失敗為師,自動生成高規格微調訓練資料
通用 LLM 部署在企業特定環境中時,常因不熟悉特有工具或工作流而失敗。ServiceNow 推出 AutoSynthData,利用「目標模型失敗、導師模型成功」的落差,提煉出結構化的「能力規格卡」,藉此生成全新的任務與驗證器。每筆生成資料均通過可行性與真實性驗證,並經歷嚴格的正向與反向驗證閘門,不合格者則由 Critic 診斷修復。在 EnterpriseOps Gym 測試中,此方法成功將目標模型的任務達成率(Pass@1)提升高達 35% 以上,顯著縮小與導師模型間的差距。