簡化多 GPU 模型部署:NVIDIA Dynamo-Triton 推出 TensorRT 多裝置整合技術
Simplifying Multi-GPU Serving: NVIDIA Dynamo-Triton Integrates TensorRT Multi-Device Inference
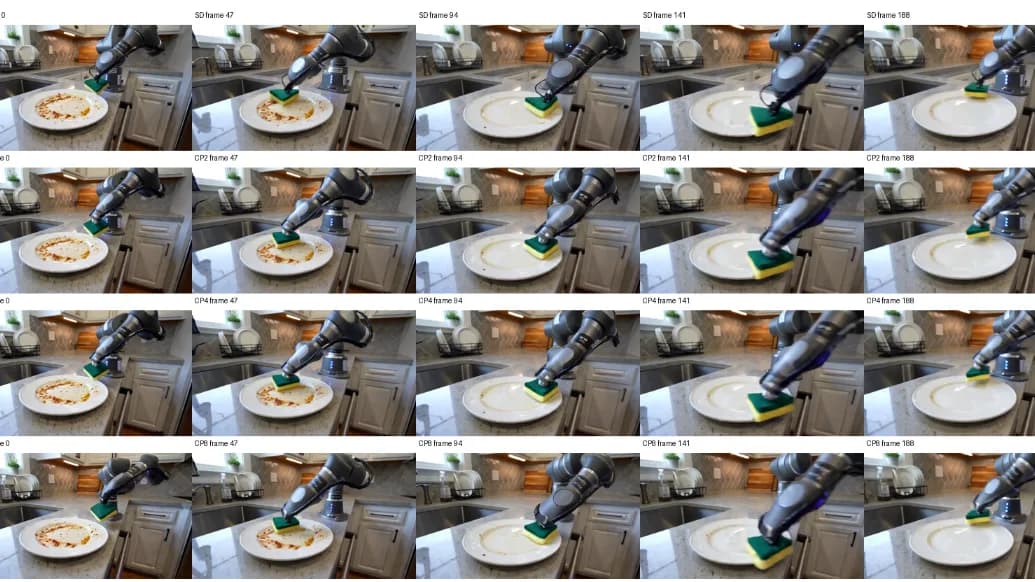
隨著生成式 AI 模型規模超越單張 GPU 的極限,NVIDIA 推出了 TensorRT 多裝置推論技術。全新 Dynamo-Triton 26.07 支援此功能,允許單一 Triton 模型實例(KIND_MODEL)自動管理多個 GPU 及其 NCCL 通訊。以 Cosmos 3 Nano 影片生成模型為例,跨 8 張 GPU 進行 context-parallel 部署時,端到端延遲從 156.6 秒縮短至 34.2 秒,Transformer RPC 加速達 6.09 倍,省去了客戶端協調 GPU 節點的複雜程式碼。
核心重點
單一 gRPC 統一端點
應用程式只需向單一模型發送 gRPC 請求,由 Triton 自動管理多張 GPU 的生命週期與 NCCL 通訊,無須在客戶端撰寫協調程式碼。
導入 Ulysses 上下文並行
在 TensorRT 計畫中編譯 Ulysses 分散式圖形,動態調整 Attention 層周圍的分割軸,使每張 GPU 均勻處理完整的序列。
顯著降低推論延遲
在 Cosmos 3 Nano 測試中,8 張 GPU 的推論時間從 156.6 秒降至 34.2 秒,讓高延遲敏感的生成式影音工作流更具實用性。
底層集合通訊優化
透過 Torch-TensorRT 將 PyTorch 算子轉換為 TensorRT 的分散式集合通訊層(reduce-scatter, all-to-all, all-gather),極大化 NCCL 的傳輸效率。
技術圖解
| SD (1 GPU) | CP2 (2 GPUs) | CP4 (4 GPUs) | CP8 (8 GPUs) | |
|---|---|---|---|---|
| 端到端平均延遲 (秒) | 156.595 | 87.999 | 53.093 | 34.183 |
| 端到端加速比 | 1.00x | 1.78x | 2.95x | 4.58x |
| Transformer RPC 平均耗時 (秒) | 146.192 | 77.548 | 42.661 | 23.993 |
| RPC 加速比 | 1.00x | 1.89x | 3.43x | 6.09x |
| RPC 耗時佔比 | 93.4% | 88.1% | 80.4% | 70.2% |
為什麼重要
對於需要部署大型生成式 AI 的企業來說,此整合消除了「多 GPU 硬體加速」與「易用推論服務」之間的鴻溝。開發團隊可以靈活地用硬體資源交換極低的推論延遲,同時保持應用程式介面與周邊工作流的穩定,不需要為了分散式推論而頻繁修改客戶端架構。
對誰有影響
- AI 開發者
- AI 研究人員
- 產品經理
- 企業決策者
可以怎麼使用
- 1大型影片生成模型(如 Cosmos 3 Nano)的多 GPU 串流推論加速。
- 2超長序列 Transformer 模型的低延遲線上 gRPC 服務部署。
- 3將複雜的分散式 TensorRT 模型計畫封裝為版本化的 Triton 服務模型。
限制與注意事項
- 多 GPU 分散式推論的輸出結果並非與單卡像素級完全一致(CP8 測得 MAE 16.316,但仍在品質指標內)。
- 此基準測試尚未評估高並發下的請求吞吐量、每部影片的生成成本或總體擁有成本(TCO)。
延伸閱讀
NVIDIA 推出 cuObject 與 SCADA 伺服器 SDK:實現免經 CPU 的 GPU 直連快取與物件儲存加速
NVIDIA Expands AI Storage Acceleration with cuObject and SCADA Server SDK
NVIDIA 宣布推出 cuObject 函式庫與 SCADA 伺服器 SDK,透過 RDMA 技術實現免經 CPU 複製的 GPU 直連儲存,並與產業夥伴共同推動開放標準,大幅加速 AI 訓練與推論的資料存取。
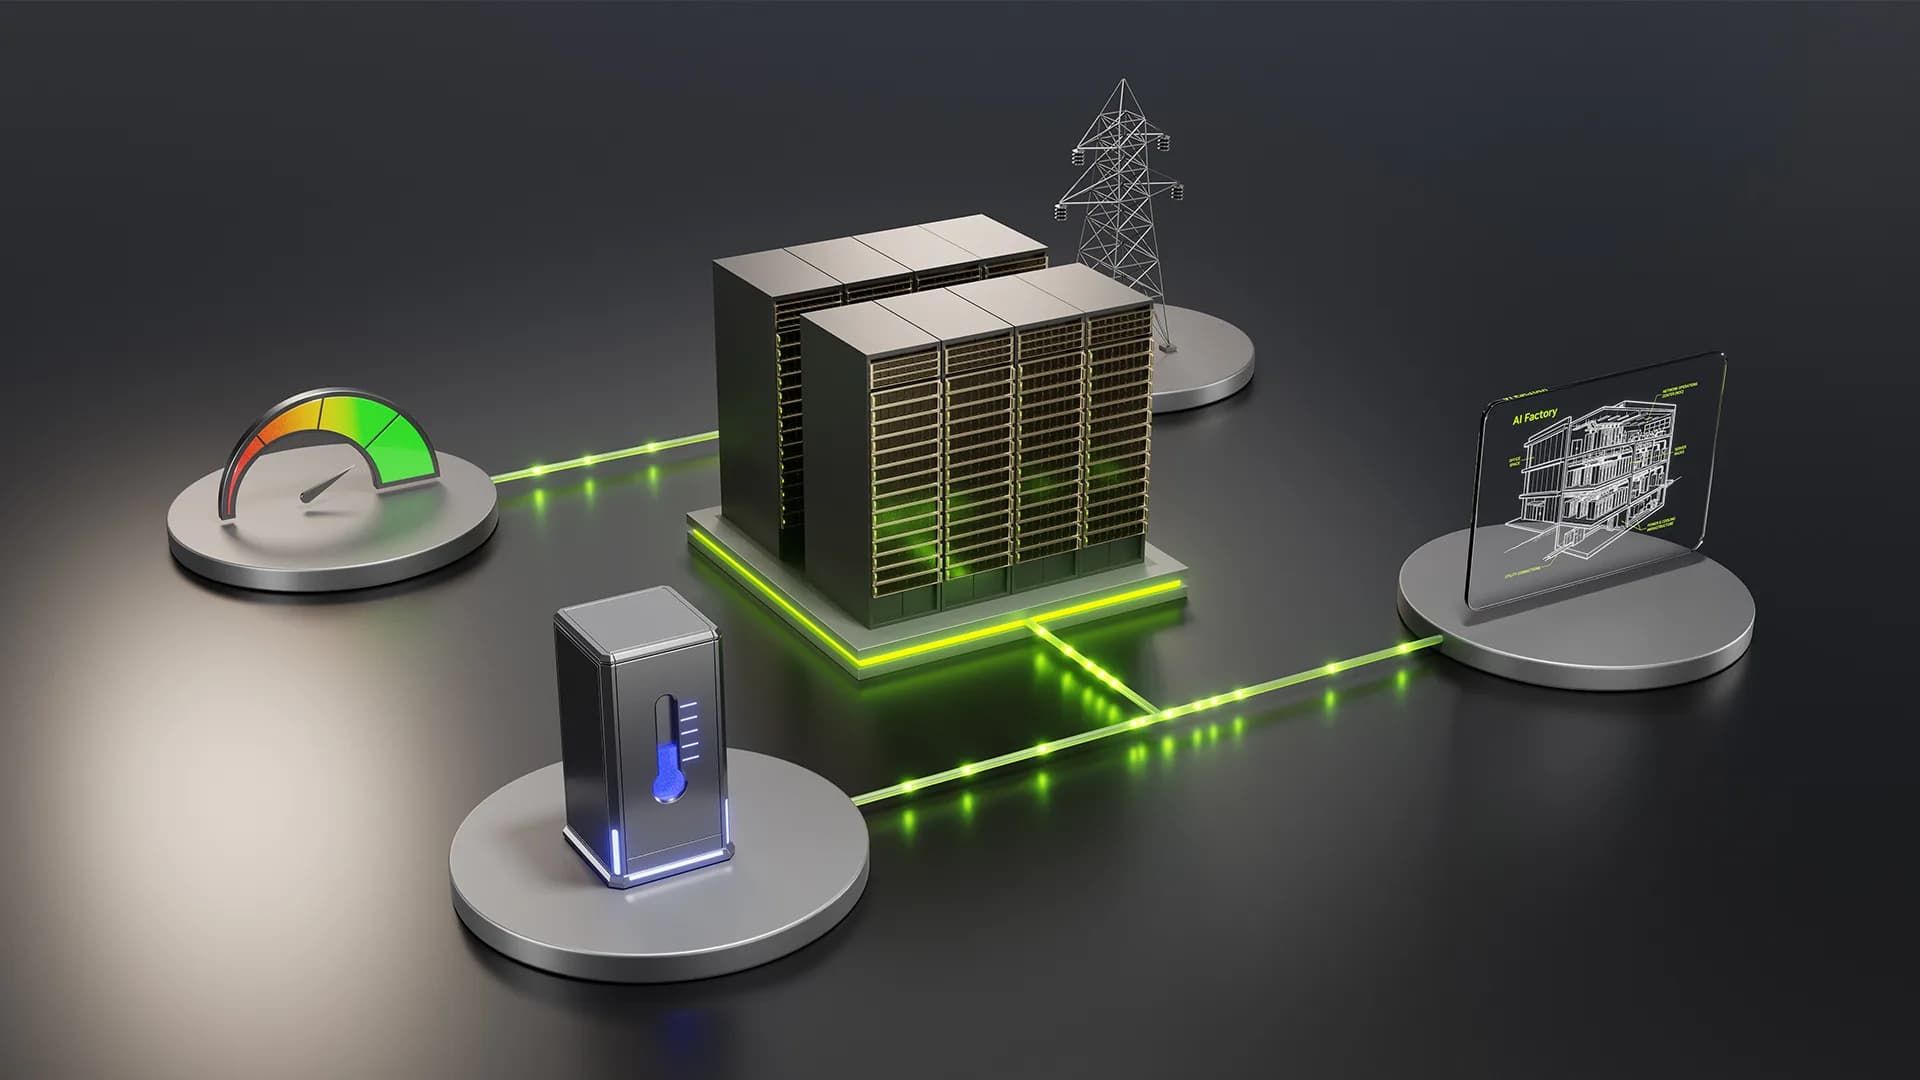
破解電力瓶頸:NVIDIA DSX MaxLPS 如何釋放 AI 工廠高達 40% 的隱形算力
Unlocking Stranded Capacity: How NVIDIA DSX MaxLPS Boosts AI Factory Throughput by 49%
NVIDIA 與 Nscale 合作評估顯示,DSX MaxLPS 藉由動態調整 GPU 電力限制,能讓同等電力預算下部署的 GPU 數量增加 37%,並使 LLM 推理吞吐量提升 49%。
NVIDIA 開源 NVCRE:在 AI 工作負載上線前,自動驗證 GPU 叢集準備狀態
NVIDIA Launches Open-Source NVCRE: Automating GPU Cluster Readiness Validation Before AI Workloads Run
傳統的 GPU 健全狀況檢查常漏掉分散式訓練中的效能瓶頸。NVIDIA 開源的 NVCRE 是一款 Kubernetes 控制器,透過主動執行分散式測試工作負載,在生產部署前精準找出故障與效能退化的節點。