AI Daily ·
機器人動態學與世界模型突破:從人形機器人端到端訓練到 3D 空間理解
Today’s AI Highlights
今天的 AI 前沿聚焦於機器人技術與世界模型的重大進展。首先,QF3 演算法透過過濾 Q 梯度實現高達 10 倍的加速,成功完成人形機器人端到端訓練與零樣本硬體轉移;同時,DepthWorld 透過聯合預測多視角 RGB 與度量深度,大幅提升機器人規劃的幾何準確性;此外,Google 也推出了 EmbeddingGemma 2,這款 740M 參數的多模態嵌入模型為邊緣 AI 提供極低延遲的向量化能力。
- 01arXiv機器人
QF3:利用過濾 Q 梯度實現快速流匹配強化學習的機器人控制技術
QF3(Fast Flow RL with Filtered Q-Gradients)旨在解決流政策(Flow Policies)在強化學習中訓練極為緩慢的問題。它透過結合流匹配與評論家(Critic)的動作梯度,並引入「一步預測」與「梯度過濾」機制,僅在重播動作附近的可靠維度進行更新。這使 QF3 成為首個能從零訓練人形機器人步態並成功「零樣本轉移」至實體硬體的離策略流強化學習演算法,且比現有同策略方法 FPO++ 快上 10 倍。
- 02arXiv機器人
DepthWorld:為機器人操控打造的 3D 世界模型
傳統世界模型僅使用 RGB 視訊訓練,生成的畫面雖合乎常理,卻缺乏穩定的 3D 幾何結構。研究團隊提出一套標定管線,將 DROID 資料集升級為高精度的 DROID-3D 資料集。並以此訓練 DepthWorld 模型,在不改變預訓練 VAE 的情況下,透過空間潛在平貼同時預測多視角 RGB 與深度,不僅讓 RGB 預測品質提升 1.48 dB PSNR,更提供精準的度量深度以供機器人進行幾何推理。
- 03arXivAI 研究
Sherpa 框架:利用強化學習訓練 LLM 進行因材施教的適應性教學
現有的 AI 助教與導師模型大多依賴預設的靜態教學規範,難以針對個別學生的學習狀況進行調整。為此,團隊開發了 Sherpa 框架,建立數個具備不同學習偏好的模擬學生模型(Student Archetypes)。藉由多輪強化學習,Sherpa 直接以提升模擬學生的答題表現作為獎勵訊號來訓練教師模型。實驗結果顯示,經 Sherpa 訓練的老師能將學生表現平均提升 20.5 個百分點,並在 MathTutorBench 基準測試中將教學評分從 52.5% 提高至 79.2%,在真人評估中更獲得近 80% 的偏好率。
- 04arXivAI 代理
利用 Web 世界模型進行對抗訓練:AdvSim2Real 提升 Web Agent 抵禦適應性提示詞注入之能力
隨著 Web Agent(網頁代理)普及,惡意網頁中的「提示詞注入」(Prompt Injection)威脅劇增。傳統防禦方法使用靜態注入進行微調,容易被自適應攻擊破解。本研究提出 AdvSim2Real 架構,在一個凍結的 Web 世界模型中,讓「任務課程生成器」、「注入攻擊者」與「Agent」協同演化。此機制不僅將 4B Agent 抵禦未見過強大攻擊的任務完成率相對提升了 33.6%,更成功將模擬環境中學到的防禦與操作能力轉移至真實瀏覽器中。
- 05arXiv機器人
VeriFine:透過協同演化驗證機制實現具身智慧的自我迭代
傳統的自我提升方法受限於固定的評估裁判(Judge),當模型策略進步並暴露出新型態的失敗模式時,舊裁判便無法提供有效回饋。VeriFine 提出雙循環機制:「策略優化循環」利用量規裁判診斷錯誤、調整適應性訓練課程來優化策略;當優化進程停滯時,則啟動「裁判優化循環」,選擇性引入人類對關鍵失敗案例的引導,透過協同校準升級裁判能力,進而指引下一階段的策略優化。此框架在自駕與機器人導航任務中成功展現了持續的自我提升。
- 06arXiv語音 AI
WorldSonus:為虛擬世界模型注入即時且具空間感的立體聲
現有的世界模型在視覺生成上已非常逼真,卻大多處於無聲狀態。WorldSonus 為此克服了即時性、互動控制與空間對齊三大挑戰。該研究提出一種串流因果自迴歸擴散架構,使音訊區塊的合成達到僅 0.41 的低即時因子(RTF);同時,透過區塊索引提示排程,讓使用者能在生成中途動態輸入聲音指令。最後,利用立體聲與一階環繞聲資料的監督訓練,使生成音效能精準契合鏡頭移動與場景幾何。
 07Google AI Developers大型語言模型
Google 推出 EmbeddingGemma 2:超輕量 740M 參數,讓裝置端擁有強大「多模態語意搜尋」與即時決策力
Google 推出開源多模態嵌入模型 EmbeddingGemma 2(740M 參數),能直接在裝置端將文字、圖片、影片畫格和音訊統一映射至單一向量空間,省去串接多個模型的延遲與記憶體開銷。在 Pixel 11 Pro 上,完整多模態模型僅需約 567MB RAM。透過全新最佳化的 LiteRT 與 MediaPipe,開發者可輕鬆在 Android、iOS 和 macOS 上實現「打字即搜尋」的離線媒體檢索與百毫秒內的零樣本意圖路由。
- 08arXiv大型語言模型
循環語言模型的「定點」重塑:邁向高效訓練、解碼與強化學習的全新架構
循環語言模型因重複呼叫網路層,每次循環都會增加訓練與推理成本。本研究發現,當循環狀態接近「定點」(Fixed Points)時,其演進路徑的影響會降低。研究團隊基於此特性改善了深度先驗與輸入注入:利用預測反饋配合熵項來學習深度先驗,並透過「正交輸入注入」消除輸入與狀態間的干涉。在 100M 至 1.6B 參數實驗中,新方法顯著降低了困惑度。此外,它實現了終端 KV 共享(減少 3 倍快取)、Prefill 速度提升 1.79 倍,且強化學習梯度計算速度翻倍。
- 09arXivAI 代理
CLIFT:基於共形自我驗證的網頁 Agent 訓練與測試端擴展技術
訓練開源網頁 Agent 面臨兩難:二元任務成功率的獎勵過於稀疏,而使用前沿語言模型當裁判又太昂貴且無法在部署時使用。CLIFT 透過「共形自我驗證」解決此問題。在訓練時,Agent 對自身執行過程回答驗證問題,並由共形保證器篩選出與訓練裁判一致的訊號以提供步驟獎勵。在測試時,凍結此驗證庫並透過共形軌跡選擇(CTS)在多個嘗試中投票選出最佳路線,無需外部裁判即可實現測試端擴展。
 10NVIDIA Developer機器人
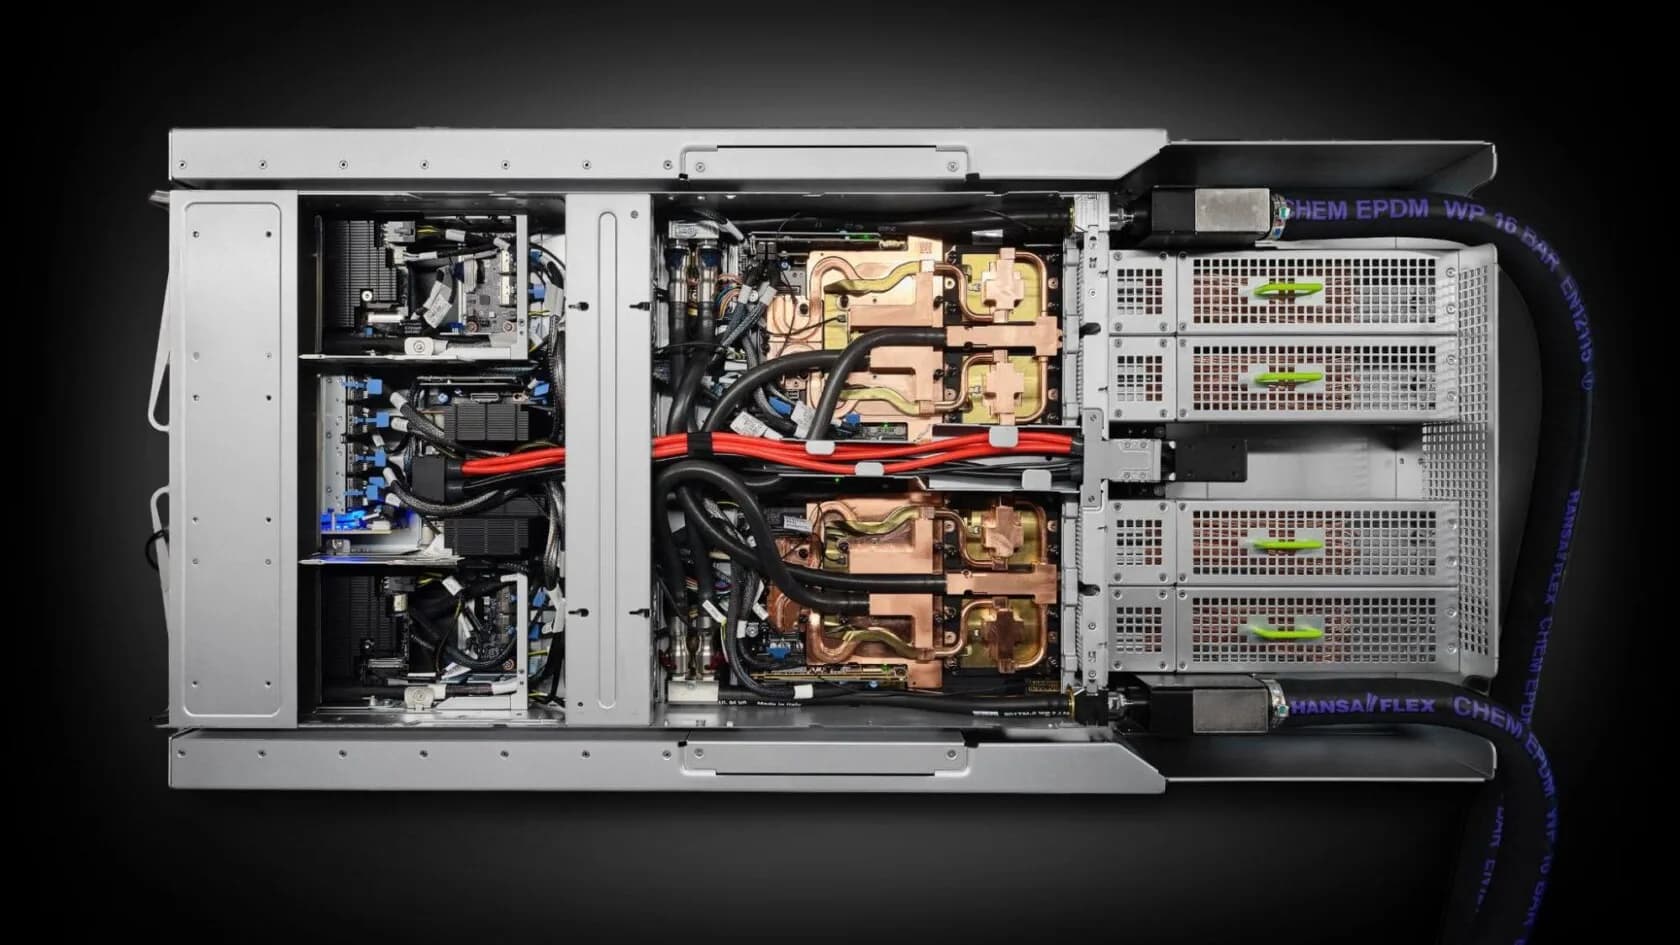
機器造機器:NVIDIA 如何用 AI 與實體控制自動組裝 GB300 測試托盤
NVIDIA 西雅圖機器人實驗室與 Isaac 團隊合作,成功讓機器手臂自動執行 GB300 測試托盤的兩大高難度組裝任務:匯流排(busbar)組裝與多接頭插拔。面對變形線材與高精密插槽等不確定性,團隊捨棄了單純的端對端深度學習,改採整合 DOPER 位姿估計、TALOS 即時控制架構、3D 列印夾爪與實體強化學習(RL)的混合管線,成功在兩大任務中達到 90-95% 以上的成功率,朝向製造端 99.5% 的嚴苛工業標準邁進。