AI Daily ·
機器人世界模型與多模態技術迎來重大突破
Today’s AI Highlights
今日AI領域迎來多項前沿突破,其中RoboJEPA透過80億參數潛在世界模型建立機器人規劃的擴展定律,Liquid AI則發表支援單次多模態推理的超快速邊緣決策模型open d1。此外,微軟推出Agent Lightning v1.0框架,全面優化代理程式的真實環境強化學習訓練,推動具身智能與代理系統邁向新階段。
- 01arXiv機器人
RoboJEPA:具身智慧的潛在世界模型與規模化法則
潛在世界模型能預測未來狀態,但其能力如何隨規模增長一直缺乏系統性評估。研究團隊推出史上最大的 JEPA 預測器模型 RoboJEPA(80 億參數),並利用跨 12 種機器人本體的真實資料進行訓練。研究證實其「想像誤差」與算力呈現二階冪法則關係,能精準預測模型品質,且該誤差與實際機器人規劃性能高度相關,甚至支援零樣本長任務規劃。
- 02arXivAI 研究
探索與優化解耦:全新強化學習框架 ExpDis 提升大語言模型的推理多元性
在具可驗證獎勵的強化學習(RLVR)中,引導大語言模型(LLM)探索新穎推理策略常會導致模型性能退化。為解決此問題,研究團隊推出「探索-蒸餾」(ExpDis)框架,將探索與優化兩階段完全解耦。該方法先訓練帶有新穎性獎勵的「探索者策略」以搜集多樣解法,經過濾後,再將正確且高質量的軌跡蒸餾至不帶新穎性獎勵的「學生策略」中。實驗顯示,ExpDis 在 7 個數學推理基準測試中皆優於 DAPO,並顯著提升了 pass@k 表現。
- 03arXiv大型語言模型
EngramEdit:透過條件記憶體實現大型語言模型的解耦知識編輯
傳統的 LLM 知識編輯常面臨模型參數調整困難或副作用大的問題。EngramEdit 針對具備「條件記憶體」的模型,提出了解耦的知識更新方案。它先計算能讓模型正確預測新事實的目標記憶體表示,再聯合更新共享的 n-gram 嵌入向量。為了避免損害其他知識,EngramEdit 會對頻繁重複使用的嵌入向量施加更強的更新懲罰。實驗證實,此方法達成了近乎完美的編輯成功率,並能流暢應用於思維鏈(CoT)多步推理,同時完整保留模型原有的通用能力。
- 04arXiv機器人
Long-WAM:突破即時控制延遲,擴展機器人世界動作模型的長上下文
本研究提出 Long-WAM 模型系統框架,解決了機器人在即時控制下因處理長視覺歷史而產生延遲的痛點。研究團隊發現「擁有歷史不等於會使用它」,只有在基礎視訊模型採用自迴歸(AR)因果預訓練時,長歷史上下文才能顯著提升控制表現。Long-WAM 先從無標記的機器人與第一人稱影片中學習因果預測,並在微調階段保留此結構。配合串流編碼、非同步執行等硬體優化,在 RTX 5090 上推論延遲僅 107.4 毫秒,並在實體 Unitree G1 機器人的動態疊杯任務中取得 95% 的成功率。
- 05arXiv機器人
機器人控制的「文字敏感症」:為何一個詞能讓 VLA 模型成功率從 100% 跌到 2%?
視覺-語言-動作模型(VLA)常因指令微小變化而失效。例如將「開爐子」改為「開加熱板」,$π_{0.5}$ 模型的成功率竟從 100% 暴跌至 2%。本研究指出此敏感性具有系統性規律,因而開發出「Rephrase Before You Act」框架:先評估少數訓練任務的多種說法,再用 LLM 提煉出 10 到 20 條重寫規則。在部署時,系統會將輸入指令依規則重寫一次後再交給凍結的 VLA 執行。此方法在不修改控制策略、不重新訓練的情況下,將 $π_0$ 模型的相對成功率提升 16% 至 27%。
- 06arXivAI 研究
AI Agent 能建立氣候模型嗎?評估未知科學領域的「SciExam for ENSO」基準測試
傳統 AI 評估多依賴標準答案,難以衡量其探索未知科學的能力。研究團隊開發了「SciExam for ENSO」基準測試,給予 AI Agent 6 小時的時間限制,僅能透過自行編寫的診斷程式作為回饋,來建構聖嬰現象(ENSO)的低階隨機模型。在測試的 12 個 Agent 系統中,有 6 個建構出的模型在重建與預測表現上超越了人類已發表的模型,且其模型結構還意外呼應了科學界對於聖嬰現象不對稱性的兩大主流學術爭議。
- 07arXivAI 代理
RECAST:透過自適應證據路由,為 LLM 計算出正確的上下文
傳統的 RAG 依賴靜態的相似度檢索,難以處理需要跨多個資料源進行篩選、聚合或計算的複雜任務。由麻省理工等機構研究團隊提出的 RECAST 框架,將證據建構視為循序決策過程。該系統由輕量化的 RouterLM 迭代選擇檢索與計算操作,並由 frozen CompilerLM 將自訂操作轉譯為可執行程式碼。一旦 RouterLM 判斷證據足夠,即交由 AnswerLM 產出解答。實驗顯示,經 GRPO 訓練的 Qwen3.5-9B 版 RECAST 表現優異,在多個基準測試中大幅超越傳統 RAG,並具備強大的零樣本泛化能力。
- 08arXiv機器人
EmbodiedRSI:首個透過「假設引導」實現自主演化與持續學習的機器人框架
當環境或指令改變時,傳統機器人基礎模型性能常會下降,且依賴高成本的遠端操作(teleoperation)數據來重新訓練。EmbodiedRSI 提出一種自我演化的 Agent 框架,建立「快慢雙系統架構」。慢速系統維護一個「假設圖」,利用「資訊價值(VoI)實驗選擇」挑選最具關鍵性的實體實驗進行驗證。實驗結果會驅動「程式-技能協同演化」並寫入「階層式記憶」,實現無人介入的持續學習。在 RoboCasa365 與真實機器人測試中,皆取得顯著優於傳統基準的成功率。
 09Hugging Face開源
Liquid AI 推出 open d1 邊緣決策模型:無需生成 Token、單次前向傳播即刻做出多模態決策
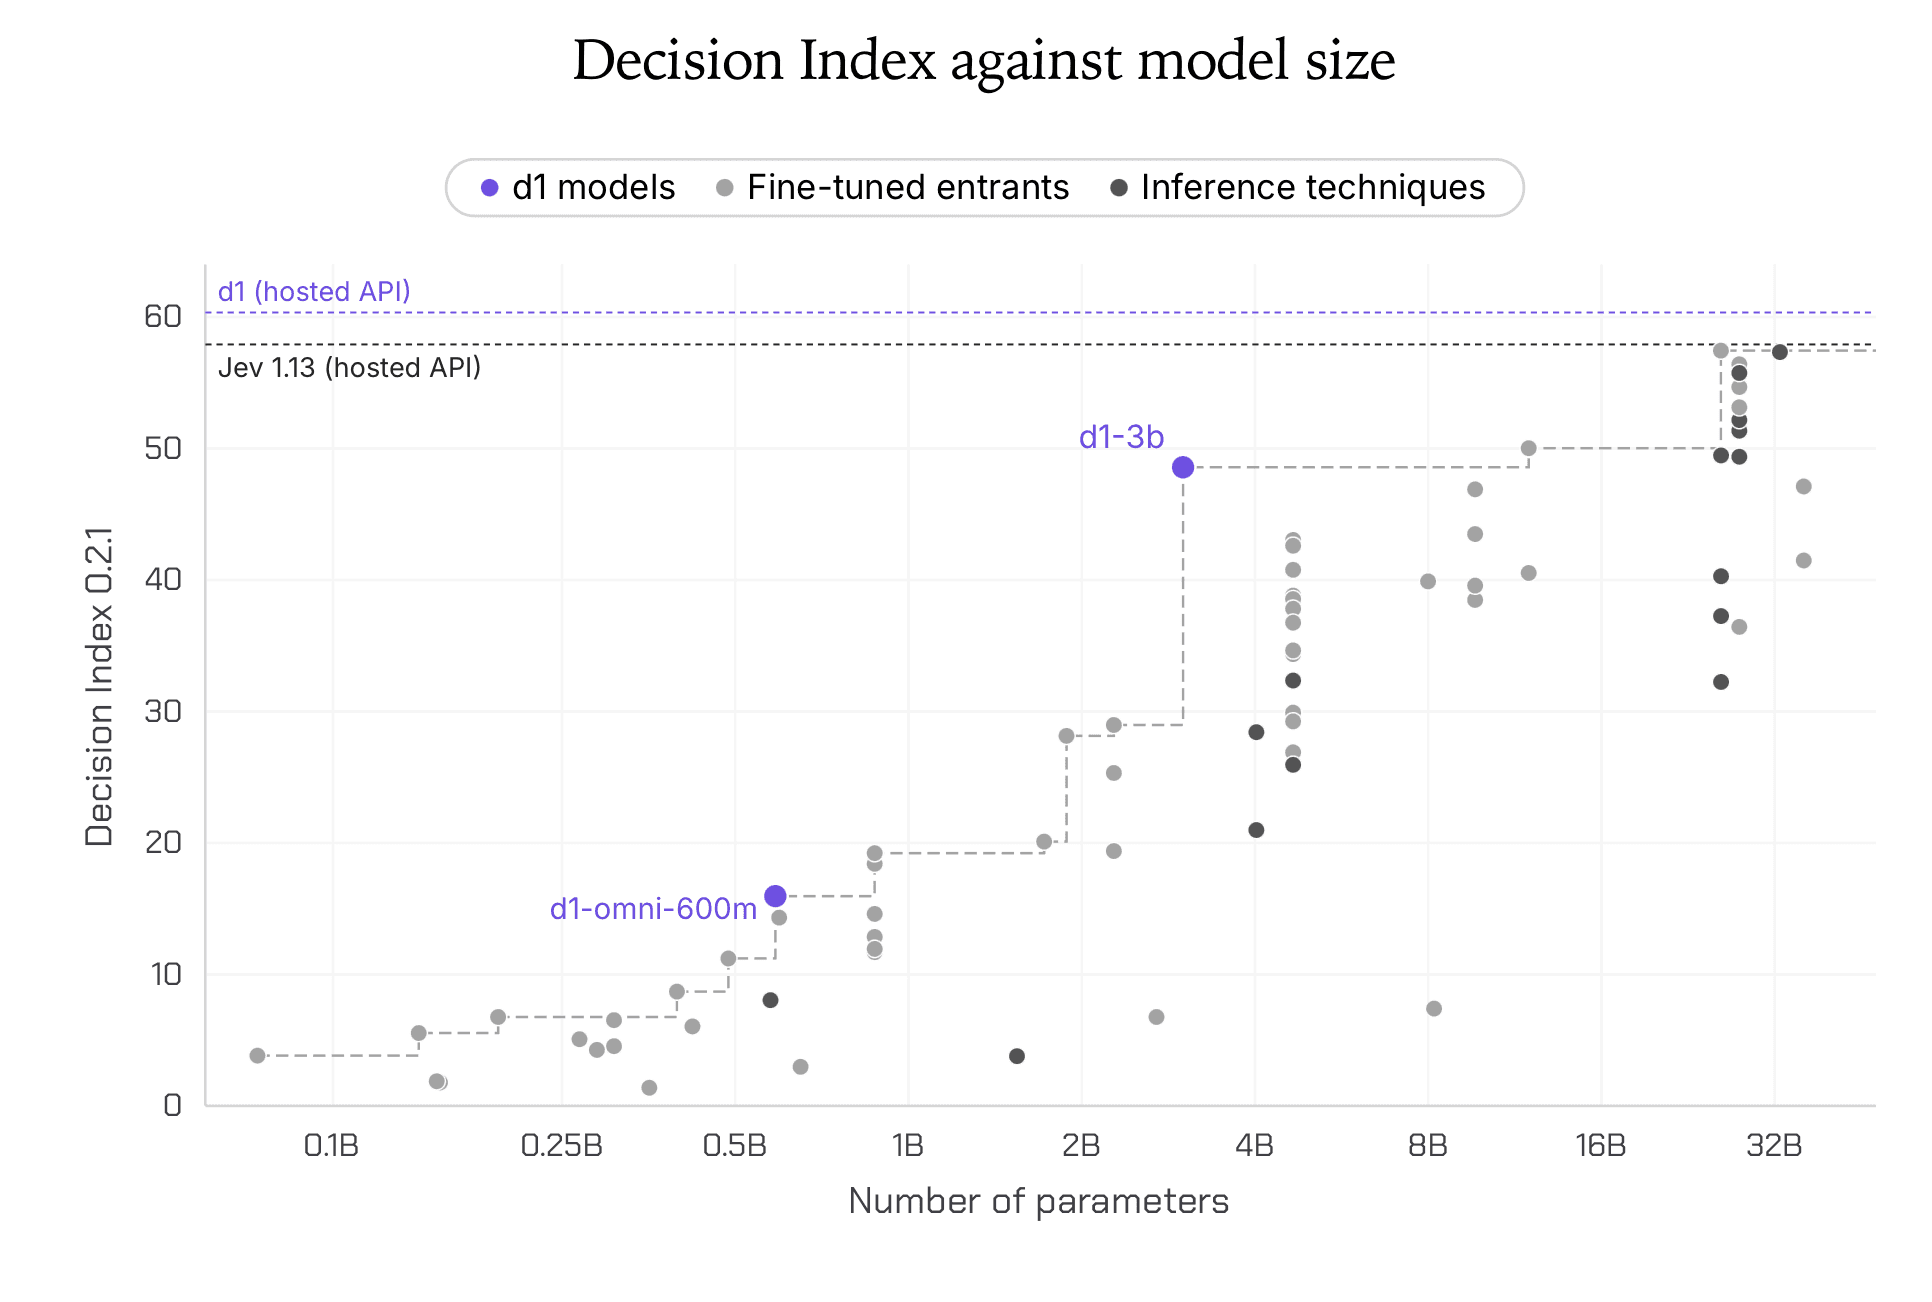
Liquid AI 發表了基於其液態基礎模型(LFM)的 open d1 系列決策模型。與傳統生成式模型不同,d1 模型不逐字生成 Token,而是透過單次前向傳播直接給出結構化答案,大幅縮短延遲。d1-3B 支援圖文輸入,在邊緣裝置(如 NVIDIA Jetson)上回答僅需不到 50 毫秒;d1-omni-600M 則為早期研究版,支援圖文或語音輸入,以僅四分之一的參數超越了 Decider 2B。
 10Microsoft ResearchAI 代理
微軟開源 Agent Lightning v1.0:僅 3,500 行程式碼,直接用生產環境 Harness 訓練 Agent 的強化學習框架
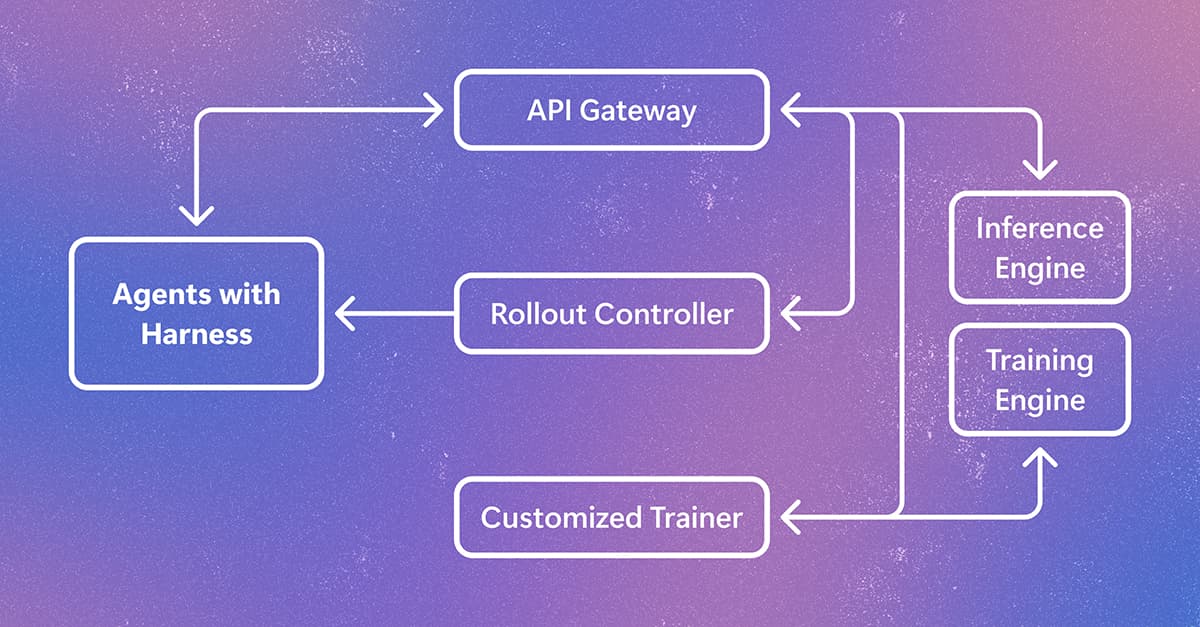
傳統 Agent 強化學習(RL)需要將 Agent 的工具呼叫與環境互動邏輯在訓練框架中重新編寫,這不僅耗費成本,更易導致訓練與實際部署的行為不一致。微軟推出的 Agent Lightning v1.0 透過在 Agent 套件與模型之間建立 LLM 代理(Proxy),實現「Harnessed Agentic RL」——直接以生產環境的 Harness 參與 RL 訓練。框架僅約 3,500 行程式碼,支援原生 Kubernetes 部署(免去商業沙盒費用),並引入「同置非同步 RL」使 Rollout 與模型更新共享 GPU,提升 2 倍訓練速度。實驗中僅用 6,000 個樣本,便將 Qwen3.5-9B 在 SWE-bench Verified 的 Pass@1 分數從 41.8% 提升至 56.4%。